我们把最近很火的逆向项目 REA 研究了一遍,发现对前沿模型意义不大
一个很自然的疑问
最近有个叫 REA 的开源项目很火,名字的意思是"逆向任何东西",在github平台上已经有了三万多star。
先说说"逆向"是什么。平时我们用的软件,都是做好的成品。做软件的人手里有一份设计稿,也就是源代码,成品是从设计稿加工出来的。逆向要做的事,就是只拿着成品,倒推出它内部是怎么运作的。这件事很有用:老软件出了毛病没人维护了,可以自己修;看到别人的软件有个好功能,可以弄明白它的原理。
REA 说自己能帮大模型做这件事。我们好奇的是另一个问题:现在的大模型已经很强了,像 Opus 5.5 这样的前沿模型,读代码、推理的能力都很好,我自己也在用opus 5.5逆向一些小东西。REA 到底给它补上了什么?如果模型本来就会,这个项目是不是多此一举?
项目介绍回答不了这个问题,介绍总会把自己说得很好。所以我们决定把它装上,实际跑一遍,再和"不用它,让模型自己来"做个对照。
动手之前,得先弄清楚它到底是个什么东西。
它不是一本秘籍
很多人第一眼会以为 REA 是一份逆向指南,像一本教人怎么拆解软件的秘籍。我们翻开看了,指南部分很薄,只有三百行左右,内容是告诉模型先看哪里、后看哪里,以及哪些结论是亲眼看到的、哪些是推测的,要分开说。
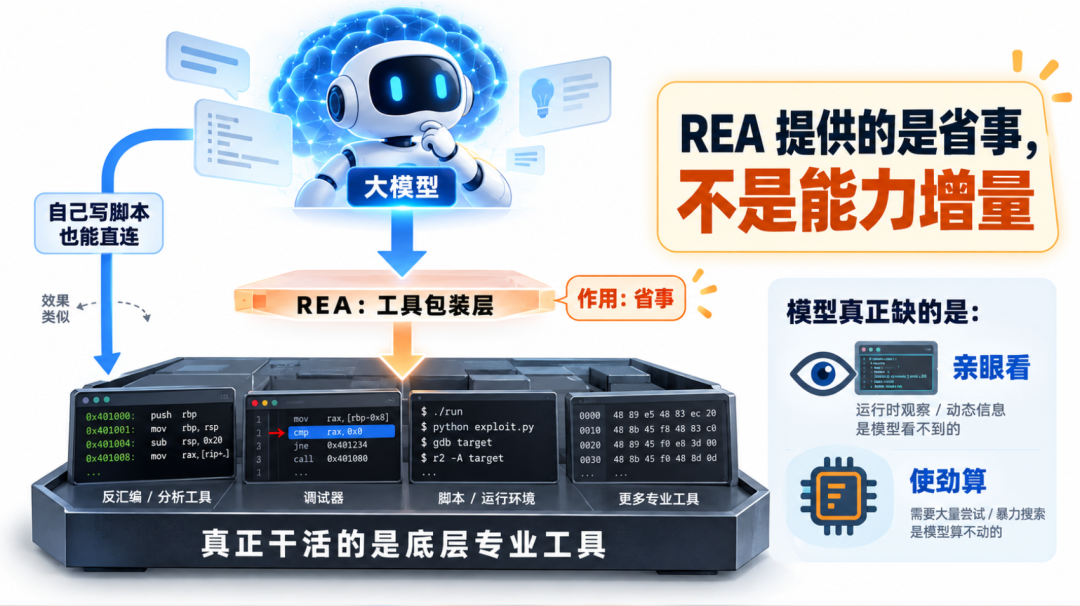
真正占大头的,是背后大约十八万行的程序代码。这些代码干的是接线员的活。逆向这一行早就有一批成熟的专业软件,有免费的也有收费的,它们才是真正干重活的师傅。REA 把这些师傅和大模型接到一起,让模型可以顺手指挥它们。
所以 REA 可以分成三层:最上面是薄薄的指南,中间是一百多个工具接口,最下面是那些现成的专业软件。它自己并不会逆向,它负责张罗。
还有两个背景。这个项目今年七月才出现,三个月里版本号从零点几涨到了六点几,更新快得惊人,大量代码是人工智能参与写的。另一个细节更关键:项目自带了一套测试题,用来检查模型用得好不好,但这套题只检查"模型有没有按规矩调用工具",从来没有比较过用它和不用它,结果到底差多少。
项目自己没回答最要紧的问题,我们只能自己做实验。
第一个实验:一个自己做的小程序
为了测得干净,我们自己写了一个小程序。输入一个名字,它会按一套藏起来的规则,算出一串对应的编号。我们把程序做成成品以后,特意抹掉了里面方便人阅读的名字,还把程序里的提示文字也藏了起来,让人没法从成品里直接看出规则。
任务很明确:只看成品,把这套规则原原本本地还原出来,还原到能自己写出一个算得一模一样的程序。
我们走了三条路。
第一条路,用 REA。它来回调用了四次,大约一分钟,把程序内部的逻辑整理成了一份清楚的"译文",照着译文就能把规则写出来。
第二条路,什么工具都不用。程序内部最原始的指令大约一百条,看起来像天书。我们把这些指令直接交给模型,它读懂了,把规则讲得清清楚楚。
第三条路,让模型自己写一小段脚本,去指挥那个免费的专业软件。脚本只有十四行,跑了十秒钟,也得到一份译文。我们把它和 REA 给的那份放在一起逐字比对,结果一字不差。
第一个结论由此出来了:在这类程序上,真正干活的是底层那个专业软件,REA 是包在外面的一层。模型自己写十四行脚本,就能绕过这层包装,拿到完全一样的结果。
当然可以反驳说,这类程序本来就有现成的专业软件,REA 帮不上忙很正常。那么换一种没有现成软件、处理起来更麻烦的东西呢?
第二个实验:一个真实的桌面软件
我们挑了一个真实的笔记软件。它的代码经过了压缩,挤得密密麻麻,很难读。任务是找出这个软件内部各部分之间互相传话用的"暗号"。
这次的数据很直观。REA 跑了三分四十六秒,输出一个七百多兆的结果文件,而我们给它的软件只有二十多兆。另一边,我们用最朴素的办法:把软件拆开,用关键词直接搜。半秒钟搜完。两边找到的主要暗号,数量和内容完全一致。
接着还有一个反转。REA 宣称自己用的是理解语法结构的高级分析,按道理应该比关键词搜索更准。可是有些地方,同一个暗号被换了一个名字来调用,这种情况下 REA 漏掉了八个,关键词搜索一个没漏。
成本上还有两笔账。REA 接到模型上之后,一百多个工具的说明书要先占掉模型一大块记忆空间;它每次返回的结果里,大约七成是附带的说明信息,真正有用的只占一小部分。
在我们测的这两件事上,REA 更慢,更占地方,也没有更准。那么它到底提供了什么?
它提供的是省事
把前面的结果连起来看,REA 的价值就清楚了。它替人把专业软件装好、接好,省掉自己配环境、踩坑的时间;它让一次分析的工作台一直开着,不用每次从头开始;它还带了一批处理冷门文件格式的小工具。
这些事情,模型全都能自己做,差别只在花不花时间。所以 REA 提供的是省事,它把成本摊薄了,并没有让模型做到原本做不到的事。
判断一个工具值不值得用,标准也就出来了。要比的是用它和不用它,总花费哪个更少:花的时间、消耗的算力、出错的概率,加在一起算。按这个标准,对用着较弱模型、又不熟悉这一行工具的人来说,REA 确实省心。对能自己写十四行脚本绕过包装的前沿模型来说,这点省事几乎可以忽略。再算上它七百兆的冗长输出,有时候用了反而更亏。
讲到这里,一个更根本的问题冒了出来:如果这类框架帮不了前沿模型,那模型做不到的逆向,是不是就再也没办法了?
模型还缺什么
回答这个问题之前,要先承认一件事:逆向这一行的方法和经验,前沿模型差不多已经全学会了。再给它一本秘籍,它翻一翻,收获很小。方法本身已经不稀缺了。
那模型还缺什么?缺两样:一样是亲眼看,一样是使劲算。
模型没法在脑子里把一个程序真的运行一百万次,看它每一步输出什么。把程序跑起来、盯着看,要靠专门的工具。模型也没法凭空想出"输入什么,程序才会走到某个特定的分支",这种需要大量尝试、反复验证的事,同样要靠工具。
这些工具才真正能让模型多一份本事。可是绕了一圈又回到原处:这些工具,模型自己也会装、也会用。多出来的本事来自工具本身,和外面那层包装没有关系。
所以这一段可以收成一句话:模型能力的增量来自亲眼看和使劲算,方法论已经给不了增量;工具有用,给工具套一层壳没有用。
亲眼看、使劲算,又引出一个更深的问题。程序就在手上,也能运行,那缺的信息,是不是只要拼命算,就全能算出来?
光靠算,能把一切都算出来吗
这是整件事里最值得琢磨的一层。答案是一半能,一半不能。分界线在于:要找的信息,到底在不在手上这个程序里。
先说能算出来的那一半。有些信息看上去像是程序之外的额外信息,其实一直藏在程序里,只是没有明着写出来。比如这个成品当年是用什么工具、按什么方式做出来的。这可以靠反复试验推断:用不同的方式重新做一遍,看哪一种做出来的结果和成品对得上。再比如程序里用到的通用零件,很多软件都会用一些公开的现成零件。把这些零件的各个版本都做一遍,逐一比对,就能认出它用的是哪个版本的哪个零件。
这里有一个很值得记住的道理:很多看起来只有别人才知道的信息,其实是别人提前替我们算好的答案。自己肯花力气,同样能算出来,只是慢一些。从这个角度说,一个完整的、能运行的程序,已经把它自身的全部行为都摆在我们面前了。
再说算不出来的那一半,一共三种。
第一种,信息根本不在手上这个程序里。有些软件把最重要的逻辑放在远处的服务器上,我们手里的程序只负责发出请求、接收回复,真正的计算发生在看不见的地方。这部分无论怎么算都拿不到,因为它压根不在我们这里。
第二种,信息在程序做成的那一刻就永久消失了。设计稿变成成品的时候,那些写给人看的名字、注释、当初的设计思路,全部被抹掉。更麻烦的是,很多份不同的设计稿,可以做出一模一样的成品。倒推的时候,我们没法确定哪一份才是当初那份。能还原出一份效果相同的好设计稿,但拿不回原来那一份。
第三种,信息确实在那里,却被设计成算不动。最典型的是用加密算法锁住的内容:要一个一个去试,就算把全世界的计算机加在一起,算到地老天荒也试不完。信息就在眼前,门却打不开。
把这三种去掉,结论就成立了:一个完整在手、能运行的程序,只要目标是做出效果相同的东西,原则上总能做到,挡在前面的只有成本。
这个结论有点抽象,我们拿两个大家熟悉的游戏来验证一下。
用两个游戏来验证
先把"彻底逆向"拆成三个层次,免得各说各话。第一层,弄懂某一个具体机制,比如游戏里打仗的胜率到底怎么算。第二层,做出一个玩起来效果完全相同的新版本。第三层,做出一个连内部排列都和原版分毫不差的复制品。
对大多数人来说,真正想要的是第二层:拿到一份能修改、能重新做成成品、效果和原版一致的设计稿。至于里面的名字是不是当年那个,没人在乎。
先看九十年代的老游戏《文明 2》。前两层,原则上都能做到,难点只在要花多少力气。如果只是想修好它的某个毛病,甚至不用还原整个游戏,只处理和那个毛病相关的一小块就够了。
再看十年前的大型游戏《文明 6》。把联网的部分放在一边,前两层原则上同样能做到,只是要花的力气比《文明 2》高出好几个数量级。它还多一道难关:这种大型游戏里很多部分是同时运行的,彼此之间的先后顺序每次都不太一样,同样的操作跑两遍,结果都可能有细微差别。这样一来,要证明"我做的新版本和原版一致",就困难得多。
那么,未来的模型如果更聪明呢?聪明能省掉的,是想错了推倒重来的那部分功夫。有些功夫省不掉:再聪明,也得把整个程序从头到尾看一遍;再聪明,验证的时候也得把东西真的跑起来,一项一项去比,这要花实实在在的时间和算力。所以往后真正的瓶颈,会从模型够不够聪明,慢慢变成验证跑得够不够快、算力够不够便宜。
另外还有一条和逆向完全不同的路:干脆不去拆成品,只看游戏玩起来是什么样,然后照着这个样子从头做一个。开源世界早有先例,有人就照着经典老游戏的玩法,从零写出了效果相近的免费版本。如果要的只是一个能自己修改的版本,这条路有时反而比拆解成品更省事。
回到 REA
绕了一大圈,再回来看 REA,它的位置就很清楚了。
它的代码是真的,装上能用,也不收钱。只是"逆向任何东西"这个名字,和它的实际分量之间,差着不小的距离。它真正提供的,是替人把现成工具张罗好的那份省事。省事有一个规律:使用者越能干,它就越不值钱。对一个已经能自己绕过包装、直接指挥工具干活的前沿模型来说,这份省事薄到几乎感觉不到,偶尔还要为它的冗长输出多付成本。
所以对用前沿模型的人来说,REA 的宣传要打个折看。它适合那些手上还没有趁手工具的人,帮他们少走一段路;对已经走得很快的人,它添不了什么。