一文讲明白 AI 短剧开源项目 Toonflow
上一篇我写了"无限画布"这个开源项目,这次我看的是一个更大的项目,叫 Toonflow。它是一个开源的 AI 短剧、漫剧制作平台,上过开源热榜 Trendshift 的日榜、周榜和月榜,还拿了 Gitee 的 GVP 认证。它想做的事情很完整:你给它一句话、一部小说或者一份剧本,它帮你写成剧本、做出角色和场景的素材图、拆成分镜,最后生成一段段视频。
我带着和上次一样的问题去看它:我平时用 Claude Code,主模型是 Opus 5.5,写剧本、调图片和视频接口这些事,它都能直接干。那这么一个平台,还有价值吗?
翻完之后,我的结论和上次不太一样:这个项目的软件部分,AI 基本都能替代;但它里面藏着一份约 90KB 的规则文档,那才是真正值钱的东西,而且模型再强也替代不了。
先说它是什么
用它做一集短剧,流程大概是这样:
1.给它内容。一句话创意、一部小说、或者现成的剧本,三选一。
2.它写剧本。只有一句话,它会先补出人物想要什么、遇到什么阻碍、结局如何,再写成剧本;给的是小说,它会改编成剧本。
3.它做素材。从剧本里找出所有角色、场景、道具,每个都生成参考图。角色是一张"四连图":脸部特写加正面、侧面、背面全身。
4.它拆分镜。把每场戏拆成一个个镜头,写清楚景别、站位、台词、时长。
5.它生成视频。为每一段写好视频模型的提示词,带上素材参考图,生成一段段几秒到三十秒的片段。
每一步做完,它会把结果摆在画布上给你看,等你点头才往下走。要花钱的生成,会先告诉你打算生成什么、生成几个。
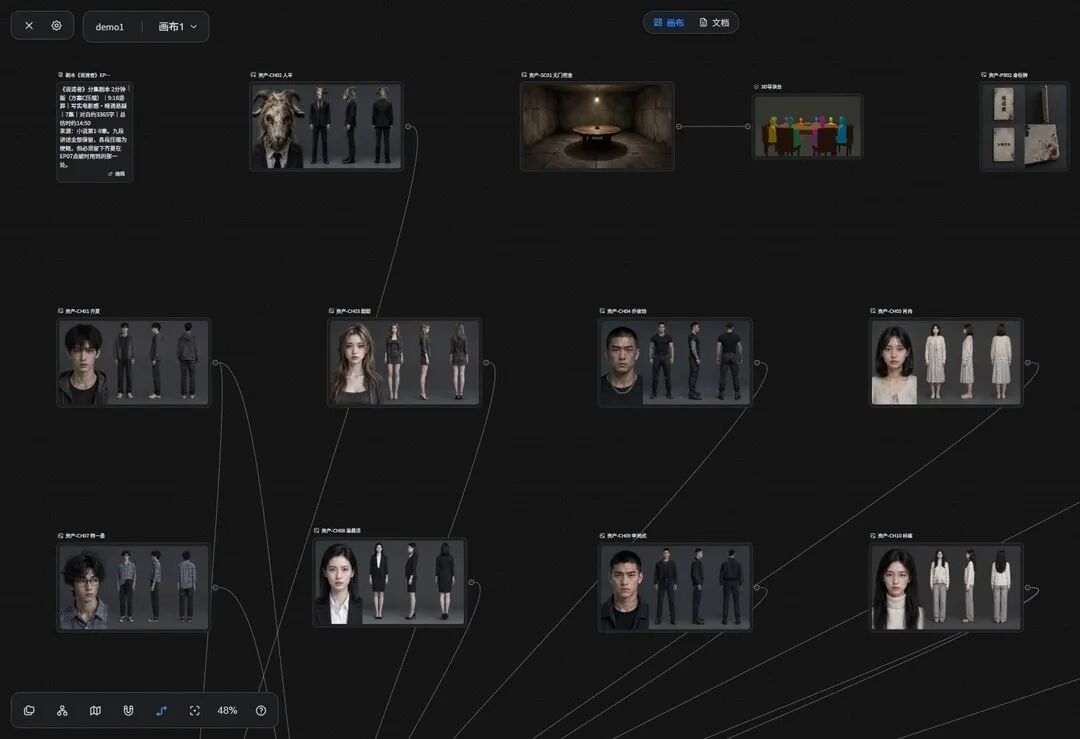
要注意的是,它最终交出来的是一段段按顺序排好的视频片段,不是一集成片。拼接、加字幕、配乐,还是要放进剪映这类软件里完成。它还故意不让视频模型生成字幕和背景音乐,原因后面会讲。
软件这一层,AI 已经能替代
这个项目的工程量不小:桌面客户端、无限画布、内置 AI 助手、插件市场、对接了好几家视频模型的接口,还在开发多租户和计费,看得出是在往商业平台方向走。
但如果你和我一样,是用 Claude Code 干活的人,这些大部分用不上。写剧本,Opus 写得不会比它差;对接视频模型的接口,Claude Code 看一眼文档就能写;多租户、计费,是人家做平台生意用的,跟个人创作无关。
有一个细节很能说明问题。我翻到了这个项目旧版本的记录:旧版把整条制作流程写死在代码里,专门写了"编剧 AI""制作 AI",用数据库存每一步的结果。到了新版,这些代码几乎全拆了,换成一个通用的 AI 助手,加上几份写给 AI 看的说明文档。
也就是说,他们自己已经承认:模型够强以后,把流程写死在代码里不值钱了,值钱的是写进文档里的经验。
所以评价这个项目,就该去翻那几份文档。
真正值钱的:视频模型的"脾气"
那几份文档里,最核心的一份是给 AI 看的"视频导演规则"。我读完最大的感受是:这是一份踩坑笔记,记的全是视频模型会怎么出错、提示词怎么写才不出错。
所有规则都建立在一个前提上:视频模型每次只生成一段,生成的时候看不到上一段长什么样。 它不像人类剧组,演员记得上一个镜头自己站在哪、手里拿着什么。它每一段都是从零开始。
从这个前提出发,规则里有几条让我印象很深。
第一,每一段都要把站位从头写一遍。 不能写"同上""延续上一段"。人物在房间里的位置(相对门、窗、桌子)、在当前画面里的左右、光从哪边来、道具在谁手里,每段都要重新写全。上一段结束时的状态,要改写成下一段开始时的状态。
第二,两段视频的接头处有讲究。 两段独立生成的视频直接接上,很容易看起来像"画面跳了一下"。规则要求:上一段最后一个镜头和下一段第一个镜头之间,以下三条至少满足一条——拍的主体不同(比如从双人换到单人),景别差两档以上(比如从中景跳到特写),或者拍摄角度差 90 度以上。一个动作要切成两个镜头完成的话,尽量放在同一段里,不要跨段。
第三,没拍到不等于不存在。 一个人手里拿着笔,剧情里没写他放下,那下一个镜头笔就不能凭空消失;就算这个镜头没拍到他的手,笔也还在他手里。已经喝过的杯子不能突然又满了,打开的门不能自己关上。
第四,文字分两种。 字幕、标题这类后期加的文字,一律不让视频模型生成,因为它生成的字经常是错的,留给剪辑软件加。包装上、招牌上本来就有的字,写"保持参考图原样,不新增、不改写",不要指望模型凭空生成清晰准确的文字。这也是它最终片段不带字幕的原因。背景音乐同理,默认不让模型加,后期再配。
第五,生成前先排查容易崩的画面。 规则列了一张高风险清单:三个以上的人同时大幅动作、双手操作小物件的同时还要复杂运镜、镜子和玻璃(容易多复制出一个人或一只手)、包装小字需要特写还要快速移动……遇到这些,先简化摄影机,再让关键的手部接触完整入画,最后才考虑拆镜头。规则还专门提醒:不要全片堆几十个"禁止"词,只对真正有风险的那一段,写一两条针对性的。
这些东西,Opus 5.5 自己不会知道。原因很简单:这些失败发生在视频模型里,不在大模型里。大模型的训练数据里没有"Seedance 2.5 的两段视频怎么接才不跳"这种知识,只能靠一次次生成、一次次失败攒出来。
第二份精华:只导演,不编剧
规则里还有一部分,叫"剧情保真"。
它要解决的问题是:AI 把剧本改写成分镜和提示词的时候,会"好心"加戏。剧本写"妈妈用湿巾给孩子擦手",AI 觉得动作不完整,会自己补上"拿起湿巾包、打开盖子、抽出一张、再擦手"。看起来更顺了,但剧本里根本没有这几个动作。如果这是一条湿巾广告,客户要的就是"擦手"那个画面,多出来的几个动作全是返工。
规则的做法是:先把剧本按顺序拆成一个个最小的事件,编上号,E01、E02、E03……最终提示词里,凡是会改变人物、道具、位置的句子,都必须能对上某个编号;对不上的,就是 AI 加的戏,删掉。AI 上一轮自己补的内容,下一轮不能当成剧情事实继承下来。剧本写"家长",就不能擅自定成"妈妈";剧本写"拿着笔",就不推断是左手还是右手。
规则里的例子大多是湿巾、包装、"父母/家长"这类,我猜这些规则是做商品广告的单子时,被客户一次次退回来逼出来的。
我觉得这一条特别有意思:模型越强,越爱润色,这条规则反而越有用。 弱模型是"做不到",强模型是"做得太多"。
还有两类经验也值得记
一是怎么保证人物前后一致。 它的做法是行业里通行的"先定妆":开拍前先把主要角色、场景、道具的参考图做出来,之后每一段视频都带上同一张参考图。角色换装、受伤、淋湿,就做一张"衍生图",记清楚它是从哪张原图变来的,只改变化的部分。
衍生图还要"累积"。比如第 2 场袖子撕破了,第 4 场徽章掉了,那第 4 场用的图要同时是"破袖子、没徽章",不能只去掉徽章,却把袖子复原了。第 6 场换了衣服,破袖子没了,但手背上的伤不会因此自动痊愈。
二是一些行业数字。 比如台词怎么算时长:字数除以语速(急促约每秒 4 个字,正常约 3 个,悲伤约 2 个),每处明显停顿加 0.3 到 0.5 秒,首尾再留约 1 秒余量。一句 24 个字的台词,大约要 8 到 10 秒,不能硬塞进 5 秒的镜头里,更不能靠加快语速解决。
商业短剧的节奏也有参考值:3 秒给出情绪入口,15 秒出现变化,45 秒形成强烈期待;付费卡点放在全剧大约 10%、30%、50%、70%、90% 的位置。这些数字对不对、适不适合你的题材,要自己验证,但起码是一个起点。
它的短板
说完优点,也说说问题。
最大的问题是,这些规则全靠 AI 自己读、自己遵守。 那份 90KB 的文档里,到处是"最高优先级""强制""绝对禁止",同一条规则反复强调好几遍。看得出他们一直在和 AI"不听话"较劲。这和它默认用的语言模型有关,写规则时面对的是能力较弱的模型。
而且,项目里的三份流程文档之间有矛盾。比如写 Seedance 2.0 的提示词时,新版文档要求按镜头写清楚时间码,旧版文档却说"写精确秒数不稳定,不要写"。到底哪个对,项目里没有给出答案。
更好的做法,我觉得是把这些规则从"文字要求"改成"程序检查"。比如让 AI 先列出每段开始和结束时,每个人站在哪、每件道具在谁手里,再用程序自动检查有没有道具凭空消失、相邻两段的接头是否满足那三条。这些都是确定性的规则,用不着让 AI 靠自觉去记。
最后
简单总结一下:Toonflow 的软件部分,用 Claude Code 这类工具基本都能替代;它真正值得看的,是项目里 packages/skills 目录下那几份规则文档,尤其是视频导演规则和剧情保真那两部分。如果你也在用 AI 做短剧或视频,建议直接去读这几份文档,收获会比装软件更大。
希望这篇对你有帮助。对 AI 做视频感兴趣的朋友,欢迎在留言区一起交流。
https://github.com/HBAI-Ltd/Toonflow-app