研究了一下用代码拍宣传片的 video-shotcraft
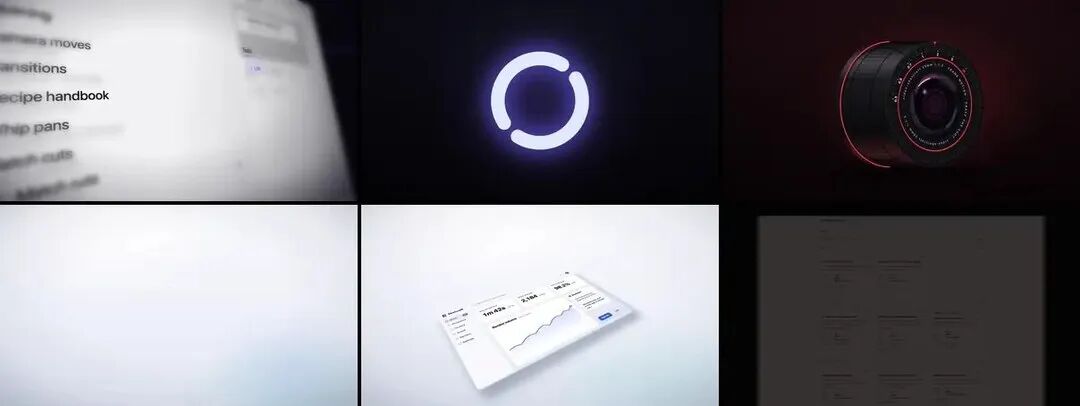
最近研究了一个叫 video-shotcraft 的开源项目。你对 Claude Code 说一句"给我的产品做一支宣传片",它会去截你产品的真实网页,从一套调好的镜头库里挑镜头、排分镜,用代码把动画一帧帧画出来,按音乐卡点剪辑、配上音效,自己逐帧检查,最后交给你一支 MP4。
它不是视频生成模型。画面里没有一帧是 AI "生成"的,全是代码根据你的截图和文案画出来的。
我带着一个问题去看:截个网页、用代码做成动画,这件事 Opus 5.5 自己也会做。那这个项目还有什么价值?
拆完的结论是:技术本身不稀奇,值钱的是作者被用户一次次骂出来的"品味",以及调了很多遍的参数。
先说一个原理:AI 视频为什么做不好片头和字卡
我研究它,起因是做 AI 短剧时总碰到一类镜头:片头剧名、人物出场介绍卡、字幕、转场、打击感特效、片尾。这些看着最简单,AI 视频模型偏偏做得最差。
原因在于视频模型的工作方式:它从一团噪声开始,一步步"猜"出像素,学到的是"大概长什么样"。而这类镜头要的恰恰是精确:
字:字是精确的符号,错一笔就是错字。中文有几千个字,训练数据里清楚的字很少;模型生成前还会先把画面压缩约 8 倍,细笔画最先丢掉。
精确到帧的时间:你没法告诉模型"第 37 帧对准鼓点"。它在时间上也做了压缩,大约每 4 帧合成一份,所以只有一两帧的闪白、顿帧会被抹平。
每集一模一样:片头每集都得完全相同,可模型每次生成都有随机性。改一个字就要整段重新生成,结果还和上次不一样。
排版:对齐、留白、准确的品牌色,模型只能做到"差不多"。
这些事对人和代码来说是确定的,所以容易;对一个靠"猜"的模型来说,正好最难。反过来,代码画不出人物和表演。两者正好互补:人物、表演、场景交给 AI,字和节奏交给代码。
video-shotcraft 就是把"代码那一半"做到了很高水平的一个项目。
第一份精华:29 条"被骂出来"的审美规则
项目里有一份审美准则,一共 29 条,分节奏、画面质感、声音、文案、流程五类。它的写法很特别,每条都是三件套:
一句规则;
判例:用户的原话,加上当时怎么返工的;
一个自检问题:验收时拿来问自己。
比如"关键信息落定后必须停够 1 秒"这条,判例里记着作者曾经停错了对象,把停顿给了普通内容卡片,结果回滚重做。
我觉得最值钱的一条是关于节奏的:整部片子收到的六次独立反馈,全部是"放慢一点 / 多停一会儿",从来没有一次"太慢了"。所以作者把规则定成:第一版默认放慢一档,开场主体的动作至少 3 秒,演示打字、点击时,要慢到观众能跟着做一遍。
这条规律不是推理出来的,是把每次用户修改的方向记下来才看出来的。而 AI 写动画的默认习惯,正好是它禁止的那些:匀速运动、节奏太快、到处加扫光、加手持抖动、每个鼓点都去震整个画面。
再挑几条:
匀速运动看起来像廉价 PPT。 速度感来自加速度:一大批元素入场要越来越快,满了以后停 0.5 秒。作者有个例子,"刷屏"效果改了五轮都不满意,换成"发牌"这个比喻,一轮就通过了。
一个镜头只给一个主角。 作者做开场"一夜推倒六次",最后定成"一个主角 + 一条完整的动作",此后到成片再没动过。
扫光一个镜头最多给主角一次,而且必须裁进圆角里。 光溢出圆角,是廉价感最典型的来源。
要读的字只有两种状态:要么是背景纹理(故意虚化,不让人读),要么达到最小字号。"想让人读却读不清"的中间状态不允许存在。
第二份精华:一套"镜头菜谱",标出不许改小的参数
项目的核心资产是 124 张"镜头配方卡",网站上能看到 150 个动态样片。每张卡写着:这个手法是什么、适合什么场景、能量和时长、参数表,还有一栏叫"命门",就是不许改小的参数。
比如打击感常用的"负片闪帧":3 帧刚好,到第 4 帧观众就会"看清"负片,效果就穿帮了;顿帧必须让整个画面一起冻住,否则看起来只是那一张卡掉帧了;连续打三下,要一次比一次狠,三下一样大就读不出"越打越狠";没有音效的闪帧,看起来像屏幕坏了。
这些卡不是一次写成的。作者先做了 216 个镜头,打磨了两轮,再人工逐个在"原版 / 第一轮 / 第二轮"里三选一,或者直接淘汰,最后留下 124 张。中间还有个教训:第一轮只加了阴影、颗粒、缓动,结果"干净但平淡",被判不合格;第二轮要求和原版并排放时,提升必须一眼就能看出来。
项目还专门叮嘱 AI:照着卡上调好的代码改,不要看卡名自己重写。按作者的说法,自己重写等于放弃了全部调校,实测质感要差一档。
这就是我说的"Opus 也会做饭,但这里给的是试过很多遍、写明火候和时间的菜谱"。
第三份精华:卡点和声音的实测坑
这部分是只有真做过才会知道的:
音乐先行。 节拍分析验收通过之前,不设计分镜。
节拍检测工具报的速度不准。 作者实测,工具报每分钟 129.2 拍,真实值是 131.97 拍。工具给出的每个拍点位置是对的,要用这些拍点自己算出真实速度;速度报成真实值的两倍(70 报成 140)也很常见,要专门检查。
鼓点是候选,不是命令。 强鼓点的曲子几乎每拍都有重鼓,要是每拍都震一下整个画面,用户的原话就是"镜头随节奏抖动"。规则是:震整个画面的冲击全片最多 3 处,其余拍点只动画面里的元素。
成片的音轨比画面晚约 1.3 帧。 原因是音频编码本身会在开头垫一小段,不是时间线写错了;每个音效文件的最响点也不在最开头,要逐个量。两项都不补的话,最重的一击会晚 0.27 秒。
声音要在画面定稿后再做。 作者第一版音效钉完,11 小时后画面大改,三次重新钉音效里有两次纯粹是画面返工连带的。
禁的是音色,不是动作。 用户嫌"太像游戏",否掉的是游戏音效包那种卡通音色,不是"点击不许配声音"。判断标准是:它像不像现实里那个东西发出的声音(快门、开关、纸、玻璃)?
第四份精华:把便宜的确认放在前面
流程上有几条,我觉得放到 AI 视频里一样适用:
用静态图定方向,不用视频。 风格先用几张静态关键帧确认,不渲染视频做提案,既贵,改方向的心理成本也高。放到 AI 短剧里就是:先出静态图确认,再花钱生成视频。
听不明白的反馈先确认指的是哪个,改错了就整体撤回,不在错误的版本上打补丁。
交付前自己逐帧检查,最后再找一个"干净"的审查者终检。 起因是用户第一次看片就质问:"你自己有截图检查质量吗?"
哪些部分可以直接跳过
Remotion 的具体写法。 那是实现,Opus 本来就会,要看的是它为什么这样调。
产品宣传片专属的套路。 比如结尾的"发布会合影"、根据品牌性格选动效参数的六个预设,都是从一部宣传片里总结出来的,作者自己也标注了只有一个判例,只能当起点。
周边工具。 导出剪映工程、上传发布、展示网站,和做视频的经验无关。
参数本身也不是定稿。 作者明确说了,镜头样片的参数是在占位素材上调的,换成真实素材还要再验。
它管不了的事
它不生成人物。 只要画面里有人、有表演,就得靠视频模型。它能做的是人物以外那一半:片头、字卡、字幕、转场、打击感。
它的经验来自产品宣传片。 节奏、能量分配这些规律能不能原样搬到短剧上,还得自己试。
最后
简单总结一下:如果你要做产品宣传片,可以直接装来用;如果你做 AI 短剧,它最有用的地方是告诉你,片头、字卡、打击感这一半镜头,交给代码比交给视频模型靠谱得多,而且这一半有一整套现成的规矩可以抄。
只想读的话,最值得看的是项目里 references/aesthetic-rules.md 这份 29 条审美准则,以及 references/music-beat-sync.md 里卡点的那几个坑。
希望这篇对你有帮助。对 AI 做视频感兴趣的朋友,欢迎在留言区一起交流。
https://github.com/Vincentwei1021/video-shotcraft