capcut-cli 攒下的这份暗规则很值钱
大家好,我是格里灰丝。
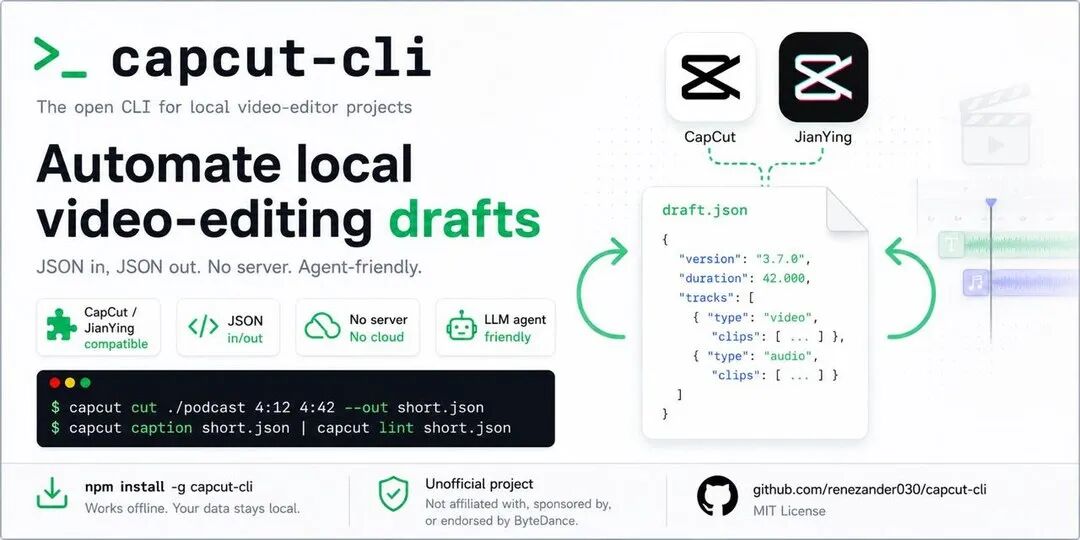
最近研究了一个叫 capcut-cli 的开源项目。它能让 AI 不打开剪映,直接在电脑上生成一个剪映项目,打开以后每条轨道都还能拖、能改。今年 4 月建仓,7 个月发了四十多个版本,攒了一千一百多个 star,还上过阮一峰《科技爱好者周刊》第 413 期。
我带着老问题去看:主模型已经是 Opus 5.5 了,它自己就能读写文件、写代码,这么一个工具还有价值吗?
拆完的结论是:有,而且很实在。代码 Opus 几天就能写出来,写不出来的是剪映这个黑盒的脾气:哪些写法它认,哪些写法它不报错、却悄悄当没看见。这个项目把半年多试出来的这类结论,攒成了一份清单和一套自动检查。
先说剪映的"草稿"是什么
在剪映里做一个项目,剪映会在电脑上存一个文件夹,这就是草稿。里面最重要的是一个文本文件 draft_content.json,记着时间线上的一切:有几条轨道,每条轨道放了哪个素材,从第几秒到第几秒,音量多大,字幕写什么、什么颜色、放在哪,加了什么动画。
剪映打开项目,就是读这个文件,把时间线照原样摆出来。
所以只要有程序能写出这个文件,项目就等于已经在剪映里做好了。capcut-cli 做的就是这件事。
capcut-cli 是什么
它是一个命令行工具,人能用,AI 也能用。给它一段视频、一段配音、一份文案,它生成一个剪映草稿。打开剪映,草稿列表里多了一个项目,时间线大概是这样:
视频轨: [clip.mp4 ─────────────────] 配音轨: [voice.wav ────────────────] 字幕轨: [第一句][第二句][第三句]
和直接导出 mp4 比,区别很大。mp4 像烤好的蛋糕,想改一句错别字只能从头再烤;草稿像分层摆好、还没进烤箱的材料,人在剪映里改一下,再自己点导出。作者在 README 里写:"发布这一下点击,始终留给人来完成。"
除了从零建草稿,它还能加素材、改字幕、调速、加转场和关键帧、用语音识别出字幕、把长视频切成短视频、翻译成多语言版本,以及检查一份草稿有没有问题。剪映和 CapCut(剪映的国际版)都支持。它还附带一份 Claude Code 技能,装上以后 Claude 就知道怎么用。
还要说明一点:它是个人开发者做的,和字节跳动没有关系。剪映的草稿格式从来没有公开过文档,所有结论都是对着真实草稿一点点试出来的。
模型这么强,为什么还需要它
读写 JSON、拼一条时间线,Opus 5.5 当然会。难处在于,剪映对很多写错的地方不报错。草稿照样能打开,你写进去的效果就是不出现。
让 Opus 从零写,它会交出一份格式完全合法、看着也对的草稿,然后告诉你"完成了"。你打开剪映,淡入没生效,逐字高亮一个字都没亮,视频没有声音。这类问题只能真打开剪映一项项试才知道,模型的训练知识里没有,推理也推不出来。
项目踩坑文档的最后一条写得很直接:JSON 写进去、存到了磁盘上,只是必要条件,算不上做完;标记完成之前,必须在剪映里打开亲眼看一遍。
第一份精华:剪映的"暗规则"清单
这份清单分散在踩坑文档和 31 条自动检查规则的注释里,不少条目还注明了来自哪个开源项目的用户反馈。挑几条最典型的。
透明度关键帧,它不认。 关键帧就是在第 0 秒标"透明度 0",第 1 秒标"透明度 100%",中间软件自动过渡,画面就淡入了。作者往草稿里写了这种关键帧,在 CapCut 上视频和文字都没有效果。正确做法是用软件自带的"入场动画",在草稿里写成动画素材。位置、大小这类关键帧倒是生效的,所以"慢慢推近"可以用关键帧做。
剪映和 CapCut 的特效编号是两套。 同一个"叠化"转场,两边的内部编号不一样。写错了,草稿能打开,转场按"什么都不做"处理。字体也一样,不认识的字体会换成系统默认,字能显示,设计全变了。只有自己导入的视频、音频、图片两边通用。
遮罩有三种写法,软件只读一种。 旧版一种,剪映 9.6 改过一次名,CapCut 又是一种。写进另外两种,遮罩不出现,也不报错。
逐字高亮的位置单位,差一倍就全军覆没。 想让"今天天气很好"里的"天气"变黄,草稿里要写"从第几个位置到第几个位置"。项目一开始算出的数是正确值的两倍。整段一种颜色时看不出问题,因为软件会把超出的部分截回末尾;一做逐字高亮,所有标记都落到文字末尾以后,一个字都不亮。为了确认正确的单位,项目扫描了 38 份软件自己保存的草稿、211 个文字素材。
复制来的视频可能整段没声音。 剪映的"分离音频"会在视频片段上留一个标记,声音放到另一条音频轨上。把这个片段复制到新草稿时,标记跟着来了,那条音频没来。
草稿必须放在软件自己的目录里。 放在别处,会提示"此草稿来自非常规路径,暂不支持"。
素材要复制进草稿文件夹。 草稿里记的素材路径可以指向电脑上任何地方,但草稿一换电脑、素材文件夹一整理,路径就断了,打开是一片黑屏。
改草稿之前,先在软件里关掉这个项目。 软件开着项目时,保存或切换窗口会把整份草稿重写一遍,外面改的内容被悄悄覆盖。
每一条单看都不难,难在事先不知道。这份清单省下的,就是一次次"打开发现没效果、回头再查"的来回。
第二份精华:字幕的几条实在经验
有剧本,就别用语音识别出来的字。 识别最容易错的恰恰是人名、术语、数字和标点,比如配音念"林晚",识别成"林婉"。可做旁白、做短剧的人手里本来就有台词原文。项目的做法是让识别只负责"每个字在第几秒",字本身用剧本里的:两边逐字对齐,识别错的字也能对上原文里对应的那个字,剧本里的一行就是一条字幕的断点。最后还会给出一个"对上了多少"的比例,用来自查。
中文字幕有单独的上限。 程序里的默认值是中文每行不超过 16 个字、每秒不超过 9 个字,日文、韩文各有一套,英文按 BBC 标准每行 42 个字母。单条字幕不超过 7 秒。代码里没有说明这组数字是实测还是惯例,拿来当起点比较合适。
竖屏字幕别放进平台界面区。 抖音、视频号这类竖屏平台,底部有标题和描述,右边有点赞按钮。检查规则会把离画面中心太远(超过 85%)的字幕标出来。
配音的时间戳,先单独验收再用。 字幕和剪辑点都依赖"每个字在第几秒"这份数据。项目总结了四种常见坏法:调错了接口,拿到的配音不带时间戳;接口超时,音频只有不到 1KB;文字和时间两组数据长度对不上;分段配音拼起来时,后一段忘了加上前面的时长,时间线中途倒回去。哪一种出了错,后面每一刀都会切偏,而且往往到成片三分钟以后才看得出来。
第三份精华:怎么对付一个会变的黑盒
剪映每次升级都可能改格式。这个项目对此有一整套做法,我觉得可以原样搬到任何"依赖别人家软件或模型"的场景。
兼容性分证据等级写。 每个剪映、CapCut 版本都标清楚:拿到过那个版本真实保存的草稿并跑过测试的;只用自己造的样本测过的;只有用户报告、手里没文件的;没测过、预计兼容的。项目明确不许写笼统的"6.x 到 9.x 已测试"。
版本一变就报警。 程序会记住上次见到的软件版本,下次写入时发现版本变了,就在提示里写出"8.7.0 变成了 10.5.0";超出支持范围的直接拒绝写入。
加密了,就老实说不支持。 剪映从 6.0 起把草稿文件加密了,社区里一直有人想要解密。作者没有做,理由写在一篇专门的文档里:法律上说不清;加密方法在小版本之间就变过,解密器得一直追着修;还有一句我很认同,"一个悄悄失效的解密器,比诚实地说'不支持'更糟糕"。他也写清了什么条件下会重新考虑:算法连续两个版本以上稳定、法律上说得清、有人愿意长期跟进。
第四份精华:给 AI 用的工具,该怎么写
多步操作写成固定脚本,不让 AI 现场拼。 技能文档里有一条硬规定:凡是要调用两次以上、要算数、要判断分支的操作,一律写成带参数的脚本,AI 只决定调哪个脚本、传什么参数。上面那份暗规则清单就是原因:AI 每次现场拼,每次都可能拼出一份看着对、其实无效的草稿;写成脚本测过一次,以后每次都一样。
看草稿从大到小,不整份倒出来。 一份草稿动辄 2MB 以上,整份塞给模型既浪费又看不清。顺序是先看概况,再看轨道,再看片段列表,最后只看要改的那一段。
批量修改要么全成,要么一条都不写。 中途有一条失败,整批作废,草稿保持原样。
作者在开发计划里还留了一句做内容的心得:"先把一个套路做到底,写成脚本、测过、在真实视频上用过,再做下一个。观众会不自觉地爱上固定的套路,前后不一致会打破它。"
和 ffmpeg-skill 放在一起看
之前我们拆过 ffmpeg-skill,它也是装给 AI 用的后期工具,走的是另一条路:用 ffmpeg 把一段段视频直接拼成 mp4 成片。两个项目放在一起看,分工很清楚。
决定分工的是一件事:剪映和 CapCut 都没有命令行导出。 capcut-cli 能把草稿写好,渲染成 mp4 必须有人打开软件点导出。项目明确把"最终渲染"划在范围之外,它自带的预览也只好用 ffmpeg 渲一个低清版。
所以两条路各有各的用处。想全自动出片,ffmpeg-skill 就够了,机器渲完自己检查,检查的就是最终版。想让人最后精修,capcut-cli 更合适,人拿到的是一份每条轨道都能改的工程。
走精修这条路,还有一个细节要留意:机器想先自查,只能用 ffmpeg 渲一版,而这一版和软件最终导出的,字体、动画可能不完全一样。机器自查通过只算初筛,人在软件里看过、导出的那一版才算数。
用之前要知道的几件事
国内剪映的新版本,草稿是加密的。 我看了自己电脑上的剪映 10.9,已有的草稿全部是密文,这个工具读不了。它新建的明文草稿,新版剪映能不能打开,项目里收到的报告有好有坏,我没有测。CapCut 国际版不加密,用起来顺很多。
一部分结论还只有用户报告。 比如剪映 11.6 读关键帧的方式变了,作者都老实标成了"有报告、没样本"。
最后
简单总结一下:capcut-cli 适合"AI 把素材准备好,人在剪映里收尾"这种分工,和直接出成片的 ffmpeg-skill 正好互补。它最值钱的是那份剪映暗规则,以及对付一个不断变化的黑盒时那种诚实的做法。
如果只想读,最值得看的是这几个文件:
skills/capcut-edit/references/pitfalls.md:踩坑清单;
src/lint.ts:31 条检查规则,每条上方的注释写了为什么;
docs/version-support.zh-CN.md 和 docs/jianying-encryption.zh-CN.md:证据等级,以及"只检测不解密"的决定;
src/align.ts:剧本和语音识别怎么对齐。
希望这篇对你有帮助。对 AI 做视频感兴趣的朋友,欢迎在留言区一起交流。
项目地址:github.com/renezander030/capcut-cli