研究了一下AI 写小说软件书童Pagekin,发现没什么价值
大家好,我是格里灰丝。
这次看的项目叫书童,英文名 Pagekin,原名「AI 小说作家」。它今年 6 月建仓,GitHub 上有两千五百个 star、三百多个 fork,到昨天还在更新。它是一个桌面软件,Windows 和 Mac 都有安装包,帮你从设定一路写到定稿。
前面我们已经拆过两个写小说的项目,InkOS 和 chinese-novelist。问题还是那个:我平时用的主模型是 Opus 5.5,写一章小说它张口就来。这么一个写小说的软件,还能帮它什么?
翻完的结论:价值不大。提示词是网文常见的写法,Opus 不需要;大部分力气花在桌面软件本身的可靠性上,和写作关系不大。真正有用的是几条被用户和实验逼出来的经验,而且证据都偏薄。
先说它是什么
书童不带模型。你在设置里填自己的 API Key,DeepSeek、OpenAI 兼容的服务、Gemini 都行,也可以用 Ollama 跑本地模型。作品存在自己电脑上。
写一本书,按这个顺序走:
1.设定页填类型、受众、总章数、每章字数。
2.架构页分四节:故事前提、角色名单、世界观、情节大纲。每节可以让 AI 生成,也可以自己写。
3.蓝图页逐章列规划:主角这章想解决什么、冲突和转折、结尾悬念、谁出场。
4.点「写第 N 章」出草稿,然后让 AI 审稿。审稿意见你逐条勾选,AI 按勾选的意见修稿,修完按段落和原稿对比,你逐段决定用哪一版,最后定稿。
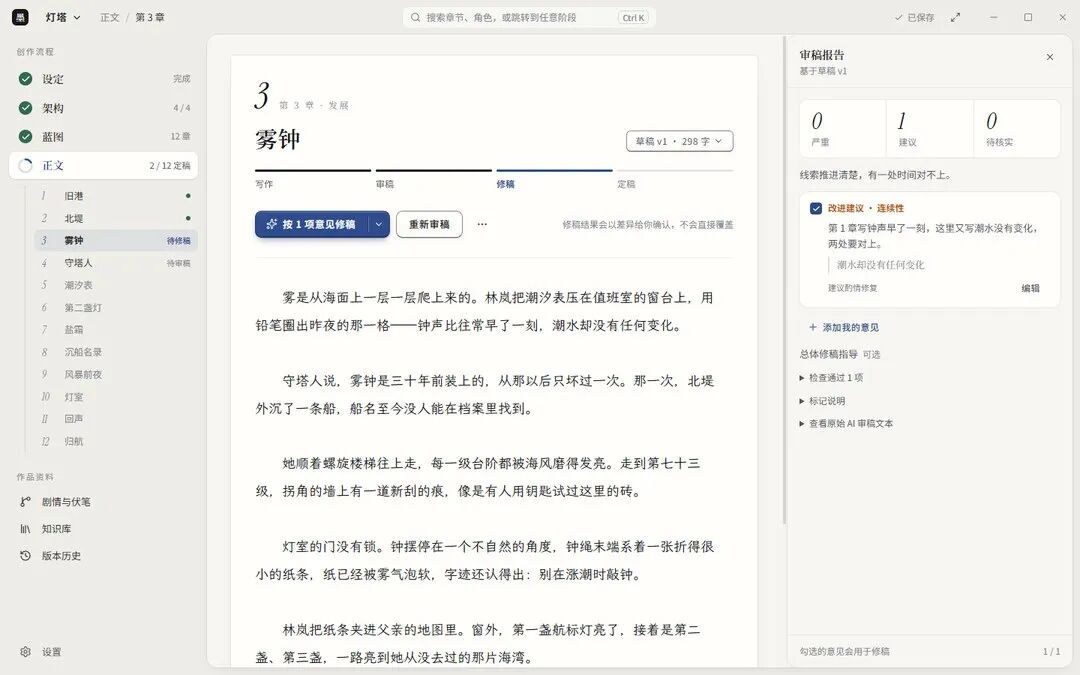
另外还有伏笔线索、角色状态、剧情树、知识库、版本历史,也能导入一本参考小说拆解来仿写,或者导入自己的原稿接着写。
为什么说价值不大
提示词是网文常见的写法。 生成蓝图的提示词要求"保姆级执行目录细纲",写着"黄金三章法则:第1章极速抛出生存高压困境,第2章激活金手指,第3章完成首次小型打脸"。写第一章要求"起笔第一句必须直接切入一个动作、一次高压审问、一场追杀"。去 AI 味的规则是"仿佛、犹如、宛如全章合计不超过3次"。这些是网文写作课的内容,Opus 本来就懂,而且懂得更多。
力气主要花在软件本身。 主进程代码四万多行,五百多个测试文件,27 篇设计决策记录。决策记录讨论的是这些事:项目切换时正在跑的任务不能借用新项目的数据,生成失败不能留下半截角色表,定稿和导出怎么做成一个整体,三个平台的安装包怎么从同一份源码发布。对一个桌面软件来说,这些都该做。用 Claude Code 写东西的人用不上。
大量文档是 AI 写给 AI 看的。docs/research 和 docs/plans 下有几十份"合同、资格、账本、门禁"式的文档,最大一份 15 万字节。随手摘一句:"新正式资格只运行 candidate;旧 baseline 字节和参考臂规则仅解释旧实验,另有改善声明需求才另行比较。"整份都是这个密度。看得出作者让 AI 代理开发,再让另一个 AI 代理审查,文档是它们之间的交接记录。人读起来很费劲,有用的结论要一条条挑出来。
它测的都不是 Opus。 项目里所有真实调用,用的是 DeepSeek V4 Flash 和 Pro、Qwen3.8-27B、GLM。后面讲的几条"模型会犯这个错",换成 Opus 不一定还会犯。
值得看的几条
下面几条我觉得值得读一读。每条都写了依据有多少。
1. 让模型"审一遍",查不出来
这是整个项目里唯一有对照数据的一条,在 docs/experiments/ 下。
作者准备了 10 个中文案例:2 个有确定错误,2 个有待核实的风险,5 个是正确的对照,1 个缺了中间章节。先把标准答案定下来,答案不进提示词。然后用两种方式审稿,每个案例各跑一次,模型是 DeepSeek V4 Flash:
普通审稿:软件原来的"一致性审稿",让模型通读找问题。
定向检查:只查关键物品在谁手里、时间条件、谁知道什么、本章该完成的事,每条要给能在原文里找到的引文。
结果:两个确定错误,普通审稿一个都没查出来,定向检查查出一个(一件关键物品的交接写错了)。五个正确的对照,两边都没误报。缺中间章节的那个案例很说明问题:普通审稿嘴上说"需要去查缺的章节",结论却照样判成矛盾;定向检查老老实实标了"不确定"。
作者从这次实验得出两个判断。一个是:只让模型给一个总体结论,没法知道它逐项查了没有。另一个是:引文是真的,不等于推断是对的。 有一个案例,定向检查的引文全对,结论还是过度了。
后来软件就改成:本章该完成的事,由程序从蓝图里拆成编号清单,模型只能逐项回答"完成、未完成、待核实",并附原文。程序再收卷:编号对不上、引文在正文里找不到、说完成却没给引文,一律改成"待核实",待核实不算通过。模型没法删掉或合并清单里的项来掩盖没写到的事。
这个思路我很认同:查什么由程序定,模型只回答具体问题,答案由程序核对。 和我们之前从 InkOS、shuohao-skills 里看到的方向一致:让模型凭记忆保持一致做不好,把清单摆到它眼前逐条核对,它做得好得多。
要说清楚的是,证据很弱。10 个案例,只跑了一次,两边只差 1 个案例,判卷的也是一个模型。改成清单式审稿以后,有没有比原来多查出问题,项目里没有对照数据。作者自己在问题台账里也写了"不能宣称通用漏检已修复":有一次作者规定了某个人物什么时候才知道某件事,材料都给全了,审稿还是没查出来。
2. 上一章的结尾,要告诉模型"已经写完了"
用户报过一个问题:第 1 章末尾和第 2 章开头几乎一字不差,同样的脚步声、同样的暗红虫子又出现一遍,时间线还往回倒。下一章开头约 700 字都在重演上一章结尾。
原因是提示词里放了上一章的结尾,却没说明那是已经发生过的事,模型当成了要接着演的材料。
作者改了两处。提示词里把这段标成"上一章已完成的结尾状态(只作边界,不可重演)",要求第一段从这个状态之后写新事件。程序再把新章开头和上一章结尾逐字比对,按 8 个字一组比,重合太多就打回。改完后跑了一次四章,相邻两章最长的逐字重合只有 5 到 10 个字。
依据:Bug 是真的,修完有一次实测。8 个字一组、重合多少字打回,这几个数是拍的,没有调过。换了说法的重演,程序查不出来,作者也写明了。另外这是在较弱的模型上出的问题,Opus 会不会这么犯,没测过。
3. 用户抱怨后加上的"别加戏"
写作提示词里,原本有网文规则:"每章结尾必须有一个让读者想连续翻页的变数"。后来加了好几条限制,方向都是只写蓝图要求的:
钩子只写本章蓝图明确要求的,不得为了制造悬念擅自新增高潮或突发变故。
金手指只在蓝图要求时才展示。
文风只管怎么写,不能为了兑现文风去加场景和事件。
从参考小说里提文风时,不能把人家"每章打几场架"这类次数学过来。
这几条都是用户抱怨 AI 加戏以后加的。依据是用户反馈,没有改前改后的对比。"钩子只写蓝图要求的"和网文、短剧"每章必须留钩子"的说法是冲突的,作者选了忠实于蓝图。我觉得两边可以都满足:钩子在蓝图那一层就规划好,写正文时不再临时加。
4. AI 生成的东西,进事实库前要过一道
用户报过"多出了没批准的角色"。改法是:定稿以后从正文里提取信息,不许自动建新角色,只有蓝图里明确声明的长期角色才能进名单。从资料里提取的角色先当候选,作者看过、再确认一次才写进去。
剧情树、角色关系图这些从正文推出来的东西,只用来看,不放回写作提示词,也不能反过来改大纲和设定。角色的当前状态逐个字段记来源,作者自己填的字段,后面自动更新不能覆盖。
这几条是设计原则,合理,没有效果数据。
5. 几个长度上的坑
这几条来自用户问题和修复记录:
字数到了目标的 82%,其实是被截断了。判断写没写完,要看接口返回的结束原因是不是正常结束,不能看字数。这条是常识,Opus 本来就知道。
目标 3000 字写出了 8455 字,直接截断会断在半句。改成整章压缩,不行就整章重写。
压缩会压过头:一次把 2863 字压到约 1835 字,又低于下限了。
中文按字节估算 token,比服务商实际计的高出 4.12 倍,结果只用了窗口三成的请求在发送前被软件自己拦下。后来作者干脆去掉了发送前按 token 拦截,超长让服务商报错。
最后
简单总结一下:书童是一个做得很认真的桌面写作软件,对习惯用 Claude Code 写东西的人用处不大,不用专门装。想看的话,只读这几处就够了:
docs/experiments/continuity-calibration-round01-results.md:审稿对照实验,十分钟能读完。
docs/plans/chapter-goal-review-production.md:清单式审稿的规则。
docs/handoffs/2026-09-05-astra-code-review.md 第 5、6 节:108 条用户问题和修法,这份比提示词有用。
希望这篇对你有帮助。对 AI 写小说、写剧本感兴趣的朋友,欢迎在留言区一起交流。
https://github.com/EthanYoQ/Pagekin