Opus 5.5 读缓存这么便宜,压缩到底还值不值?
关于大模型缓存,我之前写过几篇:《大模型缓存机制完全指南:一篇讲透 KV Cache 到 Claude Code 的省钱工程》《一文讲透大模型对话的缓存计费机制(高阶版)》《关于 DeepSeek“缓存命中率 99%”,大部分人搞混了一件事》《从对话到 Agent:缓存命中率的统一解释》《Prompt Cache 最后的4朵小小乌云》。
不敢给你们上链接了,感兴趣自己搜吧,tengxun都给我限流了,深井冰
那几篇讲的是缓存怎么回事,这篇只做一件事:算账。
起因是一个一直没想清楚的问题:Claude Code 的压缩,到底该不该用?
很早以前,我觉得压缩肯定省钱。上下文每次调用都要重新发一遍,越长越贵,压短了自然便宜。
后来 Claude Opus 5.5 把读缓存降到了普通输入价的 5%,我又动摇了。上下文读一次才 0.05 倍,再长也回复不了几次;压缩一次,却要把摘要和开头重新写进缓存,写入是 2 倍价格,这个数字看着很吓人。这么一想,压缩可能反而更贵,效果还差,干脆不压缩算了。
到底哪个对?这次我把自己电脑上近一个月的使用记录翻出来,定量算了一遍。
数据说明:
1.记录:我自己的 Claude Code 会话记录,Opus 5.5 发布以来约一个月,共 31,864 次调用、63 次压缩。
2.价格:Anthropic 官方价格页,2026 年 10 月 28 日查询。
3.适用范围:这些数只代表我的用法,换一个人,每次调用的长短、上下文的大小都会不同,仅供参考。公式是通用的,代入自己的数就能算。
文中估计的地方会单独说明,其余都是实测。
一、先把价格摆出来
缓存的规则前几篇讲过,这里只说三句:缓存只认从头开始一字不差的那一段;有效期 1 小时,每读一次重新计时;从第一个不一样的字开始,后面全部按新内容计费。
Claude Opus 5.5 的价格:
我的记录里,近一个月写缓存共 7,301 万 token,全部是 1 小时那种。所以记住一个比例:写一次的钱,够读 40 次。
读缓存 0.05 倍是 Opus 5.5 和 Sonnet 5.5 的价格,其他型号多是 0.1 倍。另外 Opus 5.5 的上下文最长 100 万 token,超长部分不加价。
二、开一个新窗口,开头的 5 万多 token 里有什么
新开一个窗口,第一次调用就要发出去约 5.4 万 token(近一个月 132 个新窗口的中位数)。拆开看:
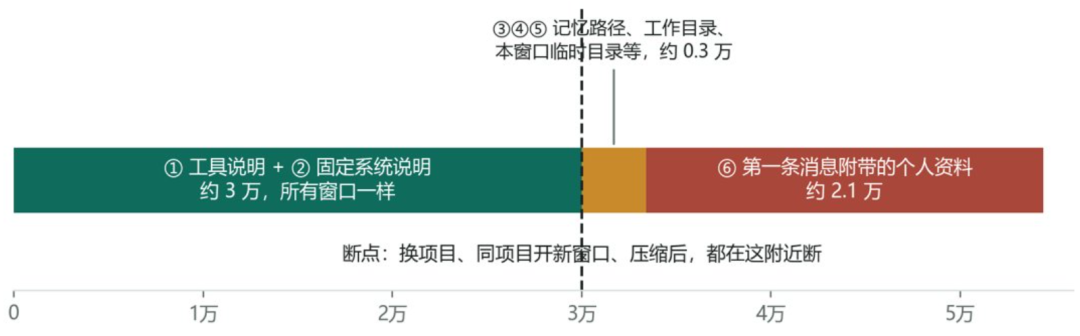
固定段的大小是实测的,随 Claude Code 版本变过,近一个月在 2.9 万~3.1 万之间;③~⑥ 各段大小来自 Claude Code 的 /context 命令,它给的是估计值,我按实际总数做了比例修正。
各种情况下,能命中多少
压缩这一行有点意外。压缩后还是同一个窗口,工作目录和临时目录都没变,按理说 ①~⑤ 都能命中。但我挑了近一个月里压缩后 55 分钟内就接着用的 23 次(多数间隔 0 分钟),读到的都只有固定段,中位数 29,839。也就是说,压缩后只能命中固定段,后面的全部重写。原因我没查清。
一个小实验:断点确实在“窗口专属”那几行
Claude Code 还有一种一次性调用的用法(claude -p),它的环境信息里没有临时目录那一行。我用它做了三次(用的是便宜的 Haiku 模型,固定段比 Opus 短,原理一样):
第一次调用就有 16,316 命中,是因为固定段对所有会话都一样,我别的窗口刚用过,它已经在缓存里了。第二次在同一目录,环境信息完全一样,所以全部命中。第三次只换了目录,就只剩固定段能命中。
这说明断点就在工作目录、临时目录这几行。普通的交互窗口每个都有不同的临时目录,所以哪怕在同一个文件夹里开新窗口,也只能命中固定段。
三、一次调用花多少钱
公式
设调用前的上下文长度为 C(都在缓存里),这次新写进缓存的是 D,输出是 R,没走缓存的普通输入是 U。以普通输入的单价为 1:
每次费用 = 0.05 × C + 2 × D + 5 × R + 1 × U读上下文 写入新增 输出 普通输入
1.D 就是“每调用一次,上下文涨了多少”。上一轮的输出、工具返回的结果、你新发的消息,都在这次写进缓存。我核对过:相邻两次调用之间,上下文平均涨 1,970;同一批调用的 D 平均是 1,953,基本相等。
2.输出要付两次钱:这次按 5 倍算输出,下次再按 2 倍写进缓存。这是真实的计费方式,不是重复计算。
3.D 只统计窗口正常运转时的调用(读缓存超过 5 万的),排除了新窗口、过期重写、压缩后这几种情况。
4.U 可以忽略:实测中位数只有 2 个 token。
每调用一次,上下文涨多少
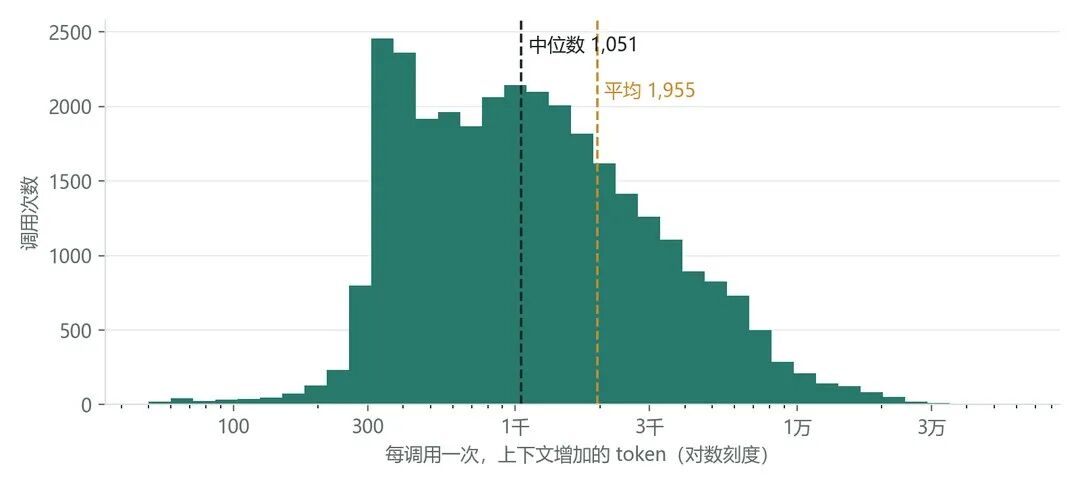
分布很偏:大多数调用只涨几百到两千,少数读大文件的调用一次涨上万,把平均值拉高了。算总账要用平均值,因为总花费等于“次数 × 平均”。代入平均值:
每次费用 ≈ 0.05 × C + 8,600 (再乘 $4/百万,就是美元)上下文越长,每次越贵
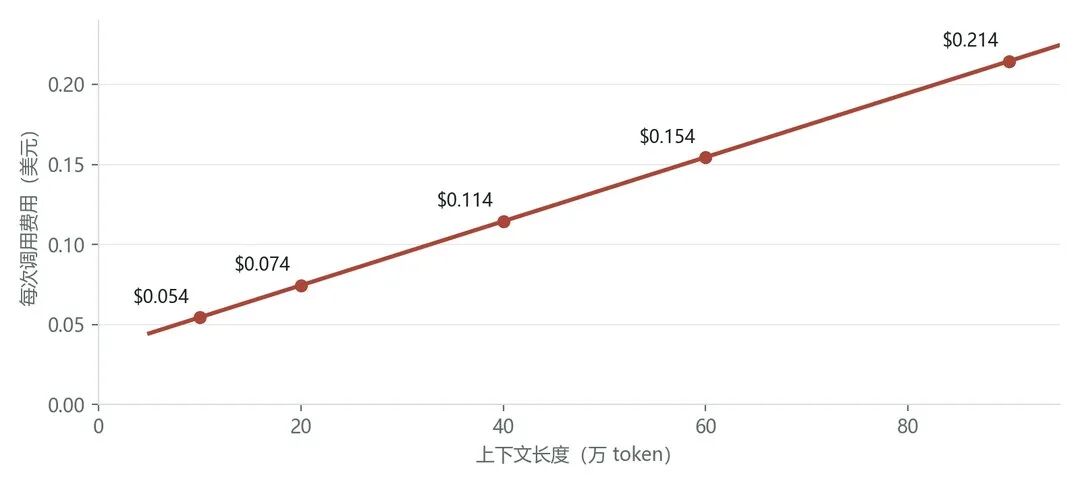
我平时的上下文有多长:
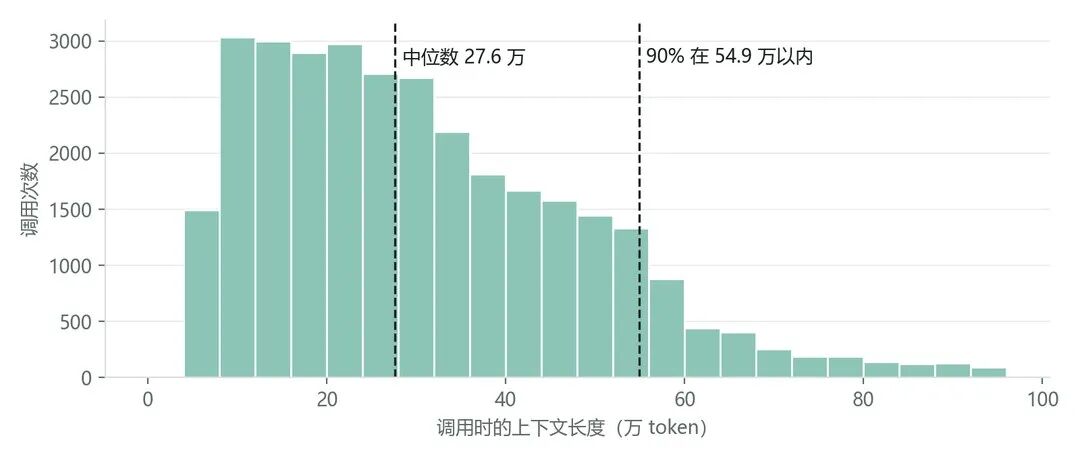
近一个月,我每次调用时的上下文中位数是 27.6 万,90% 在 54.9 万以内。
四、压缩到底值不值
比较哪两条路
从上下文为 C 的这一刻起,接下来做 n 次调用:
1.不压缩:每次都读 C,再加上后来涨的部分。
2.现在压缩:先付一笔压缩费 X,之后每次读 C₁(压缩后的长度),再加上后来涨的部分。
两条路后面每次涨多少、输出多少都一样,相减就抵消了。差别只剩两项:压缩多付一次 X,之后每次少付 0.05 ×(C − C₁)。
压缩费 X
X = 0.05 × C 压缩那次调用,把全部上下文读一遍+ 5 × S 输出摘要,S 是摘要的 token 数+ 1.95 × W 压缩后第一次调用要重写 W:本来按 0.05 读,现在按 2 写,多付 1.95 倍
回本次数
回本次数 n* = X ÷ [ 0.05 × (C − C₁) ]参数从哪来
关于 S:我把摘要原文发给模型,看它计了多少输入 token,这样量出来的,不是拿字数折算的。量的是 Haiku 5.5,我默认它和 Opus 5.5 分词方式一样。另外,压缩那次调用如果还有“思考”的输出,记录里看不到,没算进去。
在 40 万时压缩,之后会怎样
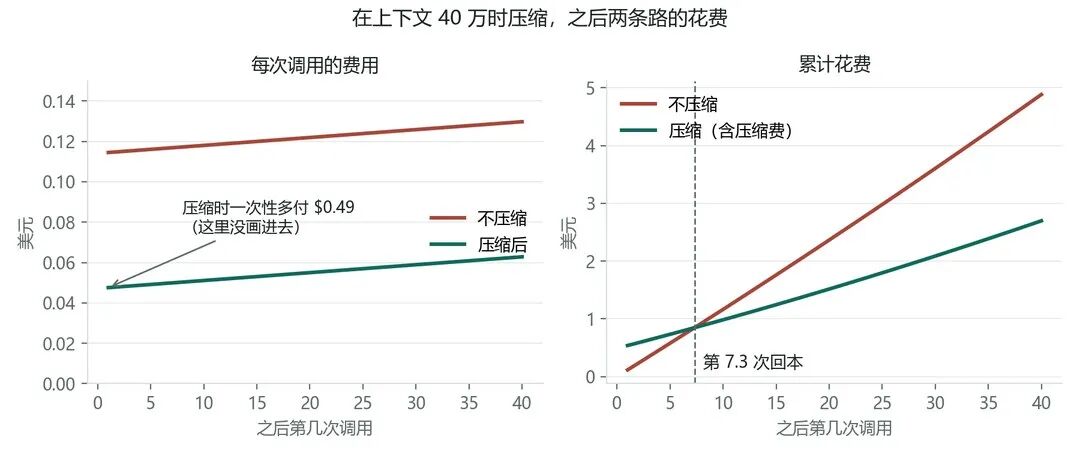
左图是之后每次调用的费用:两条线都在慢慢往上走(上下文一直在涨),但压缩后那条一直低一截,每次少付约 $0.067。右图是累计花费:压缩那条一开始就多背了 $0.49 的压缩费,到第 7 次左右两条线交叉,之后差距越拉越大。
不同上下文下的结果
“压缩后每次”指压缩后头几次调用的费用,之后会随上下文慢慢涨,但和不压缩的差距不变。“回本时上下文”是这么算的:如果不压缩,上下文会接着涨,按平均每次涨 1,955 估算,涨到这个数时,压缩省下的钱正好抵掉压缩费。它是估算值,实际每次涨多少差别很大。
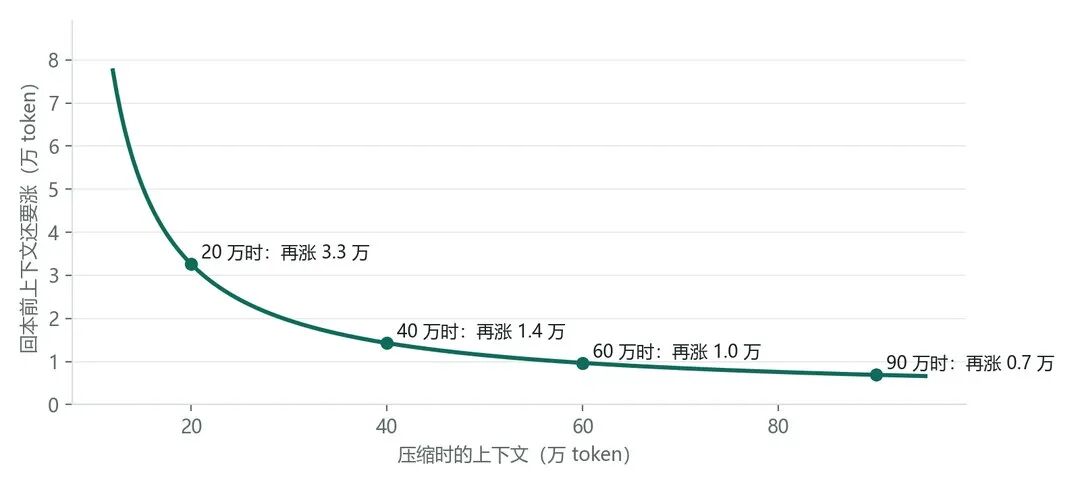
这张图是我觉得最有意思的:上下文过了 30 万以后,压缩后再聊一两万 token 就回本了。 压缩本身其实很便宜,贵的是一直拖着一个很长的上下文。我之前觉得“压缩一次写入 2 倍很吓人”,是只看了一次性的那笔钱,没看后面每次都省的那笔。
参数变动的影响(以 40 万为例):S 在 4,400~8,500 之间变,回本次数在 6.7~7.9 之间;W 在 2.4 万~4.4 万之间变(C₁ 跟着变),回本次数在 5.7~8.6 之间。结论不变。
注意
这张表只算了钱。压缩会丢掉细节,之后可能要重读文件、多返工几次,效果也可能变差,这部分没法量化,要自己权衡。
五、一次压缩的钱,够保温多久
Claude Code 还有一种“闲置压缩”:会话闲着的时候,它会自动把长对话压缩掉。我离开电脑时(比如吃饭),更想保留完整的上下文,所以把它关了,改成每 53 分钟让 Claude 醒一次,碰一下缓存,让它不过期(缓存 1 小时过期,留出几分钟余量)。
保温一次,就是一次很短的调用,主要花在把上下文读一遍:
保温一次 ≈ 0.05 × C + 1,700后面的 1,700,是按我的记录里这类“醒一下、回一句”的调用实测的平均写入和输出算的。
一次压缩的钱,够保温多久?
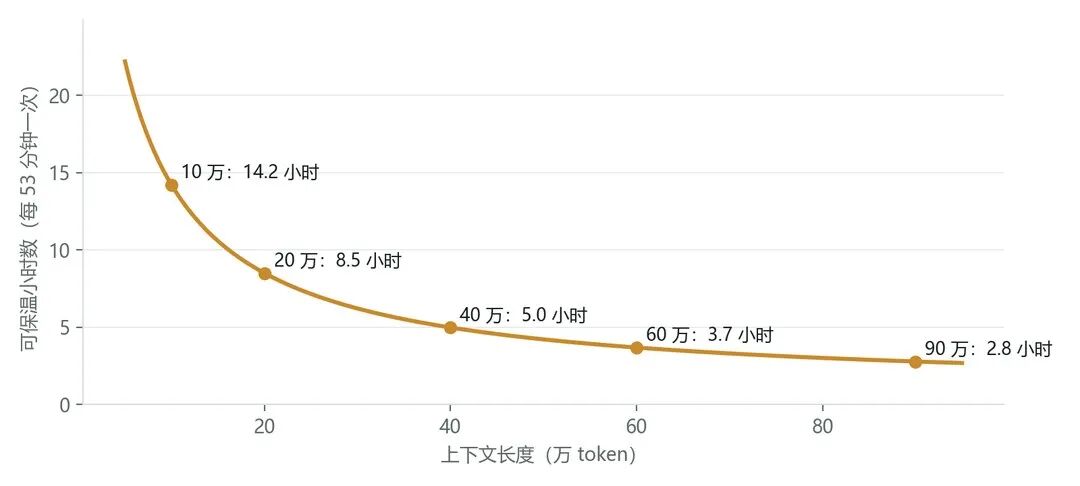
吃顿饭一两个小时,保温的钱比压缩一次还少,回来时上下文还是完整的。当然,前提是回来后还要接着用这个窗口;如果回来就开新窗口,保温的钱就白花了。
写在最后
回到开头的问题:Opus 5.5 读缓存这么便宜,压缩还值不值?
1.值。 上下文过了 30 万,压缩后再聊一两万 token 就回本。读缓存虽然便宜,但每次调用都要把整个上下文读一遍,40 万的上下文,每次调用约 $0.11,其中七成花在读上下文上。
2.压缩那一下看着吓人,其实不贵,在 40 万时压缩一次约 $0.49,相当于不压缩时多调用四五次。
3.开新窗口也不贵,开头约 3 万能命中,另外 2.5 万左右要重写,约 $0.20。
4.我的做法:上下文满了自动压缩,开着;闲置压缩,关掉,离开时改成保温。
如果你也用 Claude Code,可以在里面输入 /context 看看自己的开头各占多少,再把自己的数代进上面的公式算一算。