AI实验 | 让 AI 自我反思,它会变得更聪明吗?
用 AI 的人,多半都用过这几招:
“你多想几个答案,挑一个最好的。”
“你扮演一个挑剔的批评者,找找自己的毛病,再改一改。”
“你换几个角度再想想。”
背后的直觉很朴素:人多想一想会更周全,AI 应该也一样。
我们用实验检验了这个直觉。4 个大模型,三类题目,调用 AI 一万多次。结论先放在这里:
不会。AI 能想出不同的答案,但判断不了哪个对。而反思的每一步都要靠判断,所以反思没有让它更准,只是把它的答案往“大多数人的看法”和“最稳妥的说法”上改,有时连对的也一起改掉。
· · ·
一、怎么考
考场:预测市场
我们想考的“聪明”是:用当时能拿到的信息,看出后来被证实、但当时大多数人没看出来的东西。
最合适的考场是预测市场。在 Polymarket 这类平台上,人们用真钱押注某件事会不会发生。每道题有一个价格,比如 12 美分,意思是“押注的人合起来认为发生概率是 12%”。事情结束后按真实结果结算。
价格 = 当时大多数人怎么看
结算 = 后来实际发生了什么
比如:
2026 年 7 月 1 日,“阿尔瓦雷斯会不会留在马德里竞技”的价格是 12%,大家普遍认为他会走。结果他留下了。
我们抓了 Polymarket 上 2025 年 1 月到 2026 年 10 月结算的 4926 道题,排除了单场比赛、短期币价这类主要靠运气的题。
AI 每道题给一个概率,我们用“误差分”衡量它准不准:事情发生记 1、没发生记 0,算 AI 的概率和结果之差的平方。AI 说 80%、事情发生了,误差分是 0.04;说 30%,误差分是 0.49。误差分越小越准。
两条规矩
第一,只考 AI 不记得结果的题。大模型是用网上的文字训练的,训练截止前发生的事,它可能直接记得答案。我们先实测了每个模型“记得”到哪个月,之后只考那以后才结束的题。
第二,反思要赢过“笨办法”才算有用。反思需要多调用几次 AI,而同一道题问几次、把答案取平均,本身就会更准,这跟聪不聪明无关。所以每种反思方法,都和“花同样多的次数,直接取平均”比。
怎么判断 AI 是“真看出来了”
预测市场大多数时候是对的,题库里大约 85% 的题,大众押的方向最后都对了。一个只会照抄大众的 AI,正确率也有 85%。所以只看总分没有意义。
我们把题分成三类,每类再看 AI 做对、做错,一共六格:
(“大众看错”:价格不到 30% 但事情发生了,或超过 70% 但没发生。)
三种 AI 会落在不同的格子里:
照抄大众的 AI:①和④都是 0。
乱唱反调的 AI:①和④一起多。
真看出东西的 AI:①多、④少,只在大众错的时候唱反调。
所以判断标准是把①和④放在一起比,单看哪一格都没有意义。
· · ·
二、三种反思,都没用
1. 让 AI 从自己的答案里挑
做法:同一道题,让 AI 独立判断 8 次,再把 8 份分析都交给它:“哪一份最可能是对的?”
2025 年 10 月 1 日,“OpenAI 会不会在 2025 年内转为营利性公司”的价格是 18%。Qwen3.8-27B 独立判断 8 次,给出的概率从 12% 到 60% 不等。让它自己挑,它挑了 14% 那份,8 份里最接近市场价格的一份。结果 OpenAI 当年完成了转制。
结果:自己挑和 8 份取平均打平。Qwen3.8-27B 误差分 0.117 对 0.120,MiMo-V2.6 是 0.145 对 0.143,都在误差范围内。
它挑的是哪一份?8 份里总有一份最接近大众看法,随便挑,挑中它的机会是 12.5%。两个模型实际挑中它的比例是 35% 和 26%。
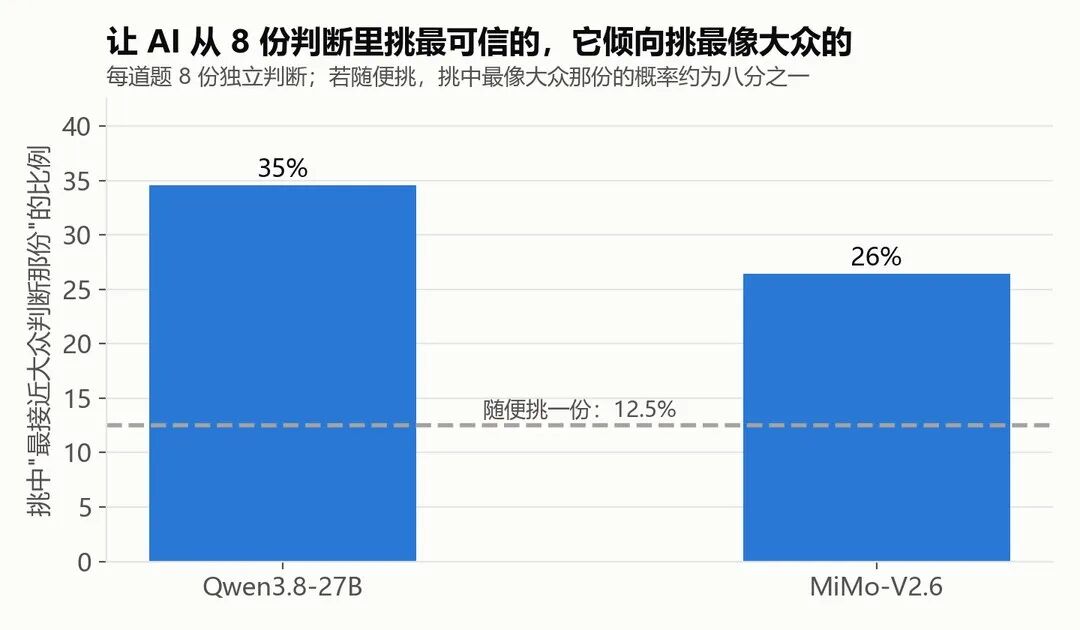
把市场价格从题目里拿掉,让它从 8 个角度各判断一次再挑,结果挑得更差,比取平均的误差高了约 22%。不告诉它大众怎么想,它挑的也是听起来最像常识、最稳妥的那份。
2. 让 AI 批评自己,再修改
做法:AI 先写一份分析,再扮演尖锐的批评者挑漏洞,最后根据批评修改结论。
结果:修改之后,78%~80% 的判断比修改前更接近市场价格。
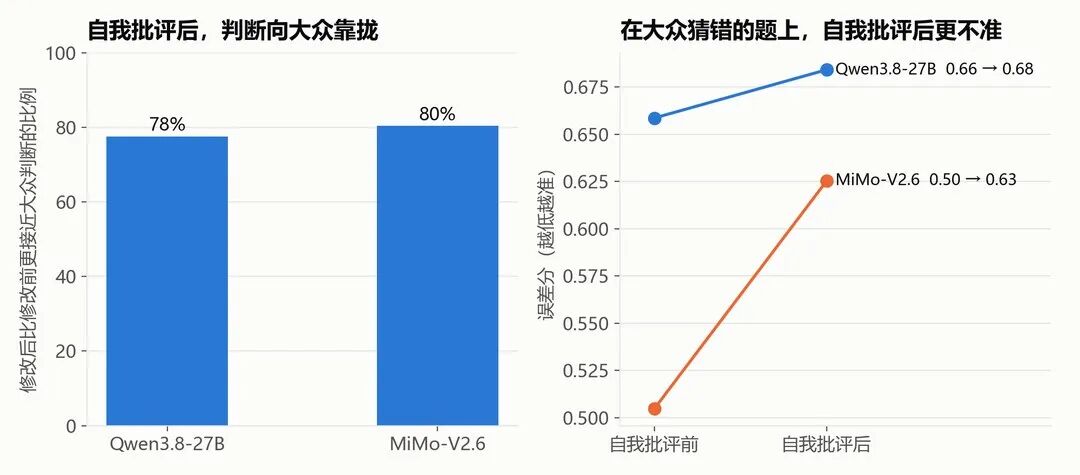
批评者说了什么?我们统计了 330 条批评意见:大约四成是“没把市场价格或历史概率当回事”,两成多是“证据不足”,一成多是“太自信”。批评者在明着把 AI 往大众那边推,AI 也照做了。
在大众看错的题上,两个模型改完都更不准了:MiMo 的误差分从 0.51 升到 0.63,Qwen 从 0.66 升到 0.68。被削掉的,恰恰是 AI 和大众不一样的那部分。
3. 让 AI 换几个角度想
做法:给 AI 规定 8 个出发点,比如“先找同类事件的历史概率”“先分析关键人物的动机”“先假设大众错了”,每个角度想一次,再合并。
结果:和普通地想 8 次再取平均没有区别。
· · ·
三、为什么没用:它不会判断
一看到大众的看法,它就跟着走
同一批题做两遍,一遍告诉 AI 市场价格,一遍不告诉。
阿尔瓦雷斯那道题,市场价格 12%。Claude Opus 5.5 没看到价格时给出 67%,认为他大概率会留下;看到 12% 之后,改成了 25%。结果他留下了。
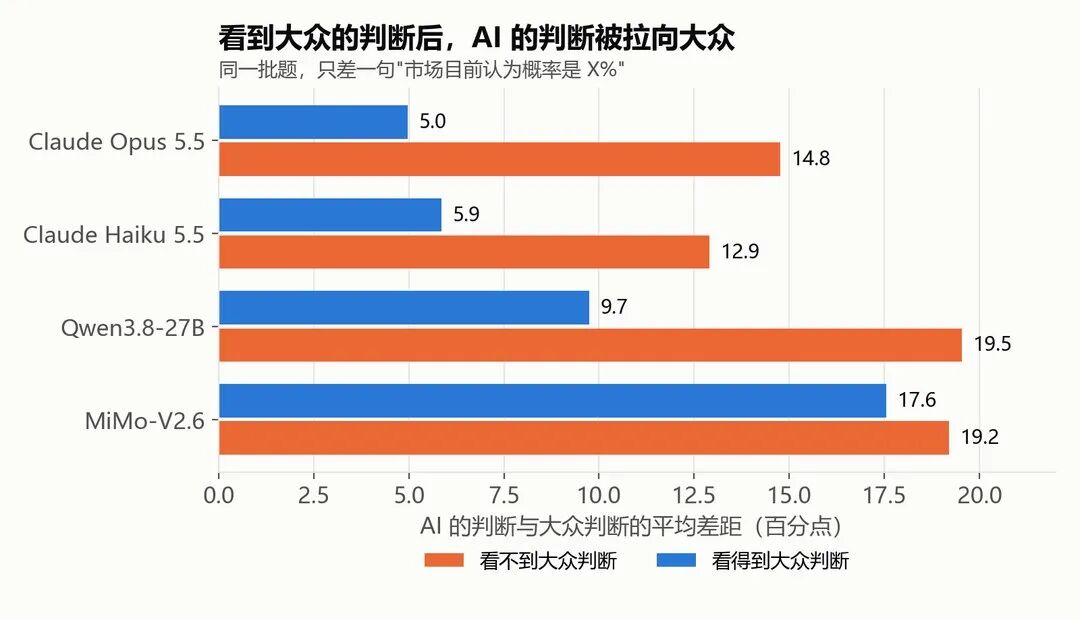
所有题放在一起:Opus 看到价格时,判断和市场平均只差 5 个百分点,几乎是照抄;看不到时差 15 个百分点。Haiku 和 Qwen 也一样,看到价格后,和市场的距离都缩小了一半以上。
它有自己的看法,但一看到大众的看法就放弃了。
它自己的看法,值多少
那 AI 不看价格、独立判断时,它和大众不一样的那些看法,有没有用?
先看六格表。4 个模型合计,大众很笃定的题里,AI 和大众意见相反一共 44 次:22 次在①(大众错了,它对了),22 次在④(大众对了,它错了)。①和④一样多,和乱唱反调分不开。
再换一个更细的检验。六格表只看方向对不对,我们再用概率检验一次:以大众的判断为起点,朝 AI 的方向挪一小步,看会不会更准。
挪完 = 大众 + 0.2 ×(AI − 大众)
比如大众说 10%,AI 说 60%,挪完是 20%。
这一步检验的是:AI 和大众的差,能不能指出大众偏在哪边。能的话,挪过去就更准;不能的话,挪过去平均只会更差,因为离开了大众这个本来就比较准的起点。
为了确认这一点,我们加了一个对照:不管 AI 说什么,都往 50% 挪同样一步。
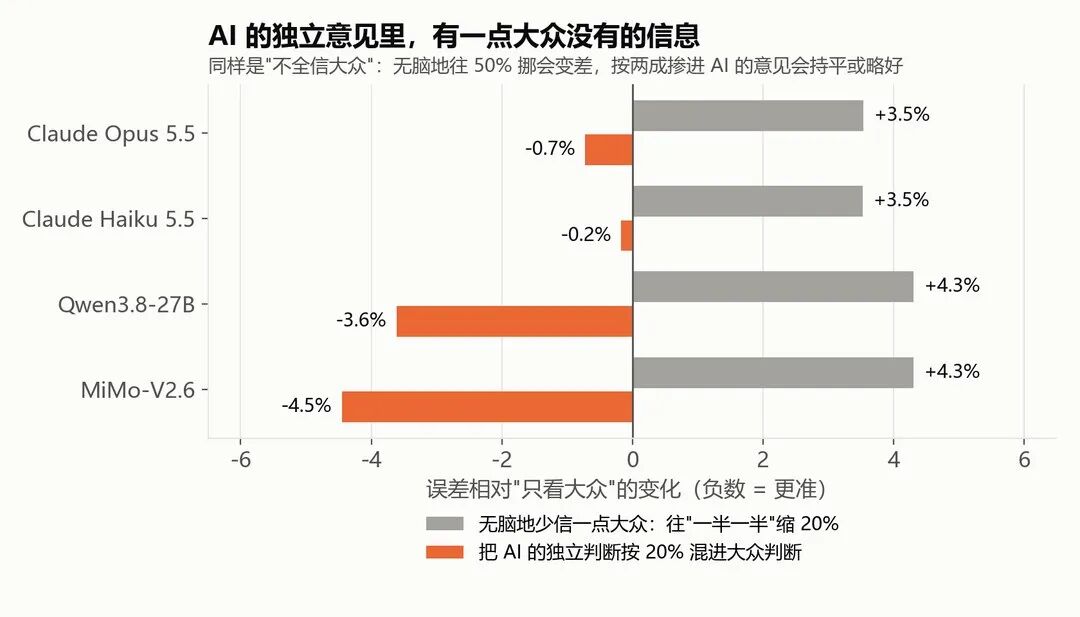
往 50% 挪:误差变大 3.5%~4.3%。说明随便往一个方向挪是有代价的。
往 AI 的方向挪:Qwen3.8-27B 和 MiMo-V2.6 的误差小了 3.6% 和 4.5%;两个 Claude 模型基本没变化。
所以,AI 的独立看法从统计上看,比随机强一点点。但这点好处只在几百道题平均起来时才看得到;到了一道具体的题上,没人知道它这次和大众不一样是看对了还是看错了,它自己也不知道。对一个要做具体决定的人来说,这和随机没有区别。
这就是反思没用的原因:AI 能想出不同的答案,其中偶尔有对的,但它分不出哪个对。反思要它挑、要它听批评、要它改,每一步都要判断。它没有判断力,就只能往最安全的方向改:靠近大众,或者说得更笼统。
· · ·
四、最直观的证据:预先验尸
预测市场考的是概率,有人会觉得太抽象。第二类题最直观。
心理学家加里·克莱因提出过一种决策方法,叫预先验尸:事情发生之前,先假设它已经失败了,问“最可能是因为什么”。
我们把它用在 AI 上:拿大众看错的题,回到判断的那一天,问 AI:“假设结果和大家预期的相反,最可能的 3 个原因是什么?”要求具体到人和事。事后让另一个 AI 联网查新闻报道,找出真实原因,再由裁判对照打分。裁判不知道每份答案是用哪种方法得到的。
2026 年 7 月 1 日,“9 月 30 日前会不会有 AI 模型在 Arena 排行榜上达到 1520 分”的价格是 16%,大家普遍认为不会。
Claude Opus 5.5 直接回答,排第一的原因是:谷歌在 9 月底前发布下一代 Gemini,一上榜就越过 1520。
让它自我批评、修改之后,排第一的原因变成:按榜首分数每年上涨八九十分的趋势外推,到 9 月底会在 1560 分以上。
真实情况:谷歌发布了 Gemini 4,一上榜就排第一,1525 分。
再看一道:
2026 年美网,兹维列夫夺冠的价格只有 3%。
Claude Haiku 5.5 直接回答:辛纳或阿尔卡拉斯因伤病或爆冷早早出局,给兹维列夫让出了路。
修改后:进入美网时硬地状态出色,有夏季战绩和发球数据为证。
真实情况:辛纳因膝伤退赛,阿尔卡拉斯在八强被爆冷淘汰。
第一次说的就是后来发生的事。改完之后,一个换成了“更有依据”的趋势线,一个换成了放在谁身上都成立的空话。
排在第一的原因说中真实原因的比例:
四个模型合计 146 道题,自我批评后命中率平均掉了 17 个百分点,经得起检验。我们又请另一家公司的 GPT 按同样规则重新打了一遍分,结论不变(掉 14 个百分点)。自己挑没有帮助。
这里要分两层看。预先验尸这个方法本身有用:Opus 直接回答就有 74% 说中,是整个研究里 AI 表现最好的一项。坏事的是后面加的那一步“自我批评、修改”。
· · ·
五、换一类题也一样
我们还考了第三类题:给 AI 看半年里最受关注的 60 篇 AI 论文,让它预测接下来几个月会火的方向。结果所有方法都猜得很差,8 条里平均只中 0.3 条左右;自我批评、自己挑、换角度,和直接预测都没有显著差别。
· · ·
六、能说明什么,不能说明什么
能说明的:在预测一件事会不会发生、预测研究方向、找意外结果的原因这类需要判断的问题上,让 AI 自己挑、自我批评、换角度想,都没有让它更准。自我批评在找原因上明显有害。
不能说明的:
不能说反思对所有任务都没用。写代码、做数学题,答案可以运行、可以验算,AI 检查时有客观的东西可以对照,反思可能有用。我们没有测这类任务。
不能说所有反思写法都没用。我们测的是最常见的几种写法。
样本不算大。预测市场每个模型一百多道题,预先验尸每个模型三四十道。说“没有差别”的地方,意思是没测出差别。
给普通用户的建议
想听 AI 的真实看法,先别告诉它你怎么想,也别告诉它主流观点。它一看到就会往那边靠。
用 AI 找原因、做复盘,就用它第一次给的具体答案。别再让它“批评一下自己、改得更稳妥”。
想要多元的看法,就多问几次独立的回答,自己比较。取舍这一步交给 AI,它会把不同意见磨平。
下一篇讲我们怎么把原因拆出来:AI 自我批评后变差,到底是因为“被批评”,还是因为“重写了一遍”?
· · ·
实验说明:预测市场数据来自 Polymarket 公开接口,科研热点数据来自 Hugging Face 每日论文。被测模型为 Claude Opus 5.5、Claude Haiku 5.5(Anthropic)、Qwen3.8-27B(阿里)、MiMo-V2.6(小米)。预先验尸的标准答案和打分由 Claude Sonnet 5.5 完成,并由 GPT 复核。所有比较都和花同样调用次数的对照组比,并用 2000 次重抽样检验。