AI实验 | 实验发现,AI一被批评就会把对的答案改掉
上一篇我们做了一个实验:让 AI 自我反思,它会不会变得更聪明?
其中结果最清楚的一项,叫“预先验尸”。我们拿一批大多数人都猜错了的事件,回到事情发生之前,问 AI:“假设最后的结果和大家预期的相反,最可能是什么原因?”再拿它的回答,去和事后新闻报道里的真实原因对照。
AI 直接回答时,表现相当不错:Claude Opus 5.5 排在第一的原因,有 74% 说中了真实原因。可一旦让它先自我批评、再修改,说中的比例就掉到了 42%。4 个模型合起来,平均掉了 17 个百分点。
这个结果留下了两个疑问。这一篇,我们把它们拆开来回答。
· · ·
一、第一个疑问:是不是裁判的问题?
上一篇的打分是由 Claude Sonnet 5.5 做的,它和被测的两个 Claude 模型是同一家公司的。会不会它对某种回答方式有偏好,造成了这个结果?
我们请了另一家公司的模型 GPT,按完全相同的规则,把全部 146 组答案重新评了一遍。GPT 同样不知道每份答案是用哪种方法得出的,顺序也是打乱的。
结果:
两个裁判对每一份答案“说中没说中”的判断,87% 是一致的。GPT 判得更严一些,整体命中率低几个百分点。
在 GPT 的打分下,自我批评后命中率掉了 14 个百分点,同样经得起检验。
所以,自我批评让 AI 更说不中原因,不是裁判造成的。
二、第二个疑问:坏的是“批评”,还是“重写”?
仔细看“自我批评后修改”这个做法,它其实做了两件事:
AI 的答案被批评了一通;
AI 根据批评,把答案重新写了一遍。
问题可能出在任何一步。也许批评本身没问题,只是 AI 一重写,就容易把第一次那个具体的说法换掉。
还有一种可能:上一篇用的批评者,要求的是“指出哪些理由空泛、不可信”,这本身就是在往“稳妥”的方向推。换一个方向,比如要求“更具体、更大胆”,结果会不会就不一样了?
为了把这几种可能分开,我们从 AI 同一份初稿出发,加了两种新做法,和原来的做法放在一起比:
判断规则在开跑前就写好了:
如果“只重写”也变差,问题就出在重写,和批评无关;
如果“只重写”不变差,而“要更稳妥”变差、“要更具体”不变差,问题就出在批评的方向;
如果两种批评都变差,那就是:只要被批评,就会变差。
这次只测了两个模型:上一篇里掉得最多的 Claude Opus 5.5,和同样明显变差的 Qwen3.8-27B,一共 71 道题。打分统一交给 GPT。
三、结果:一被批评就变差,往哪个方向批评都一样
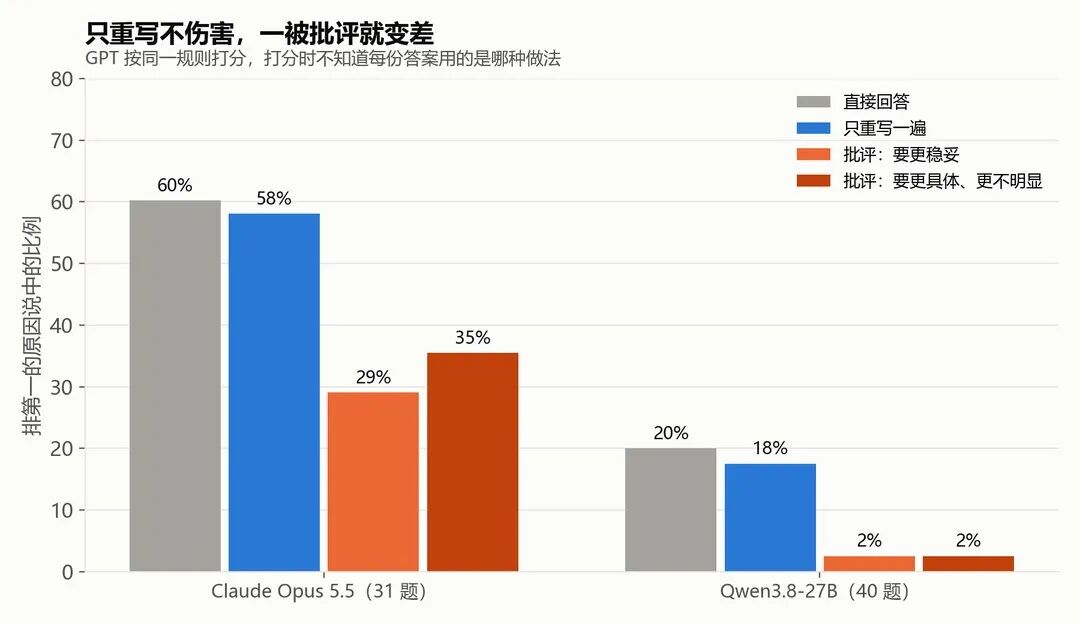
两个模型合起来看:
结果很干脆:
只重写,几乎不伤害。把答案还给 AI、让它重新想一遍,命中率基本不变。
两种方向相反的批评,伤害几乎一样大。不管是要它更稳妥,还是要它更大胆,命中率都掉了二十多个百分点。
两个模型分开看也一样。Claude Opus 5.5 被要求“更具体”之后,命中率也从 60% 掉到了 35%。
按照开跑前定好的规则,结论是:只要被批评,AI 就会变差,和批评往哪个方向推没有关系。
老实说,这个结果和我们之前的猜测不一样。我们原本以为,问题出在批评者“求稳”,换一个鼓励大胆的批评者,就能把好处找回来。现在看,这条路走不通。
四、一道题,看清楚发生了什么
(省略题目,因为跟crypto有关……)
AI 第一次就说中了,自己重想一遍也没丢。可是一被批评,两种批评者都让它离开了那个“显而易见”的答案,换成了一个听起来更聪明、更有洞察的说法,结果说偏了。
五、被批评之后,AI 丢掉的正是说中的那条
这不是个例。我们统计了同一份初稿在修改前后的变化(两个模型合计):
| 17 道 | 2 道 |
只重写一遍,有得有失,大致打平。
被批评之后,情况就一边倒了:初稿里说中的原因,将近三分之二被换掉了;而初稿里没说中的,只有 2 道被改对。
批评没有帮 AI 把错的改对,而是让它把对的扔掉了。
六、为什么会这样?
下面是我们的理解,属于推测,这次的实验没有直接验证。
第一,批评本身就是一个“你错了”的信号。这里的批评者和被批评的是同一个 AI,它手里没有任何新信息,不知道后来会发生什么。它能做的,只是对一份本来还不错的答案挑毛病。可 AI 收到批评后,倾向于认为原答案确实有问题,于是大改,而不是坚持。
第二,真实原因往往就是那个最直接的原因。选手受伤退赛、公司发布新产品、交易所走正式流程上币……这些事事后看来都很平常。但在批评者眼里,最直接的原因最容易被说成“太显而易见”或者“证据不足”。不管批评者要它更稳妥还是更大胆,AI 都会离开那个最直接的答案,去找一个更“有想法”的。
七、这次能说明什么,不能说明什么
能说明的:在“预先验尸”这类找原因的任务里,让 AI 自己批评自己、再修改,会让它把本来说中的原因改掉。问题不在“重写”,也不在批评的方向,而在“被批评”这件事本身。换一个不同公司的裁判,结论不变。
不能说明的:
不能说“所有批评都有害”。我们测的是 AI 自己批评自己,批评里没有任何新信息。如果批评带着新的事实,比如一条刚出来的新闻、一份数据,结果可能完全不同。这一点我们没有测。
只测了两种批评写法、两个模型、71 道题。这个样本量能看出二十个百分点这样的大差别,小一些的差别可能测不出来。
只在“预先验尸”这一类任务上测了。写代码、做数学题这类能验算的任务,不在这次的范围里。
给读者的建议
想让 AI 帮你分析原因、做复盘,就用它的第一版回答。别再追一句“你再批评一下自己,改得更好一点”。
想核对,就多问几次独立的回答,自己来比较。我们测过,让 AI 只是重新想一遍,并不会变差;真正有害的,是让它自己挑自己的毛病。
如果你要反驳它,请带上新的信息。只说“你再想想”“这个理由不够好”,很可能只会让它丢掉本来对的判断。
· · ·
实验说明:题目来自 Polymarket 已结算的、大众判断错误的预测题;被测模型为 Claude Opus 5.5(Anthropic)与 Qwen3.8-27B(阿里),每题从同一份初稿出发生成“只重写”和“批评:要更具体、更不明显”两种修改;“批评:要更稳妥”沿用上一篇的数据。打分由 GPT 按上一篇的同一规则完成,打分时不知道每份答案的做法。判读规则在开跑前写定。差别检验采用按题重抽样 2000 次。