研究了一下口播视频项目 video-talkcraft
大家好,我是格里灰丝。
最近研究了一个叫 video-talkcraft 的开源项目。它是 video-shotcraft 作者的另一个作品,前者用代码给产品拍宣传片,这一个专做口播视频:给它一份口播稿和一条配音,它在你电脑上把每个字说出口的时刻算出来,再用代码一帧帧画出字卡、图表、划线圈注、网页"镜头",最后渲染成一条解说视频。我照例带着老问题去看:主模型已经是 Opus 5.5 了,写动画代码它自己就会,这个项目还有价值吗?
拆完的结论是:有价值,但不在"全自动做口播视频"这件事上。值钱的是三样东西:用户一次次挑毛病换来的审美规则,一批实测出来的数字和坑,以及 108 张动效卡参数表里的"手感值"。这三样 Opus 自己推不出来。
它到底是干嘛的
先把几件容易误会的事说清楚。
输入是稿子 + 配音。 两样都有是默认用法。只有稿子也行,它可以调用 Fish Audio 的接口合成配音(有免费档)。只有录音不行:算每个字的时间必须有稿子当标准答案,因为语音识别出来的字常常错。
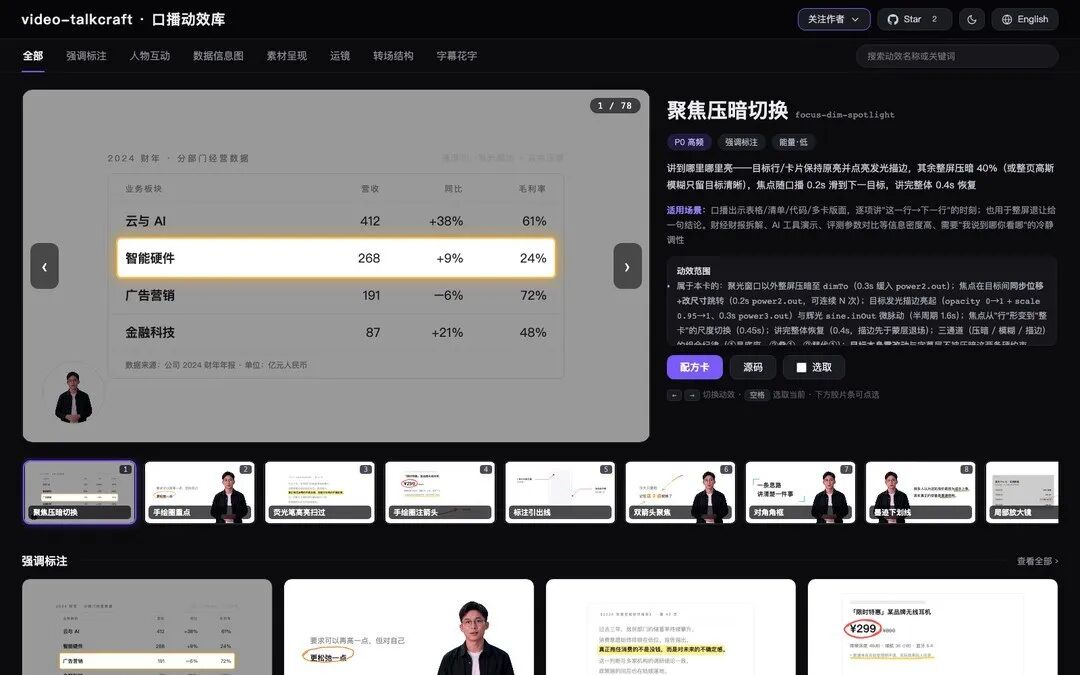
画面不是 AI 生成的,也不是从素材库里"匹配"来的。 项目里没有任何视频生成模型。画面有四个来源:
代码画的动效:字卡、数字、图表、划线、转场,这是大头;
自动截的网页:它用 Playwright(一个能自动操作浏览器的工具)打开页面,截一张整页长图,同时量出要标注的元素在哪,后面像拿镜头一样在长图上滚动、放大、划重点;
素材站的实拍空镜:AI 按每一镜的内容写几个英文关键词,去 Pexels、Pixabay 搜索下载。搜索靠的是上传者填的标题和标签,所以只能搜到"城市人流""机房"这类泛泛的画面;
你自己提供的出镜人物视频,它负责抠像、缩到角落。
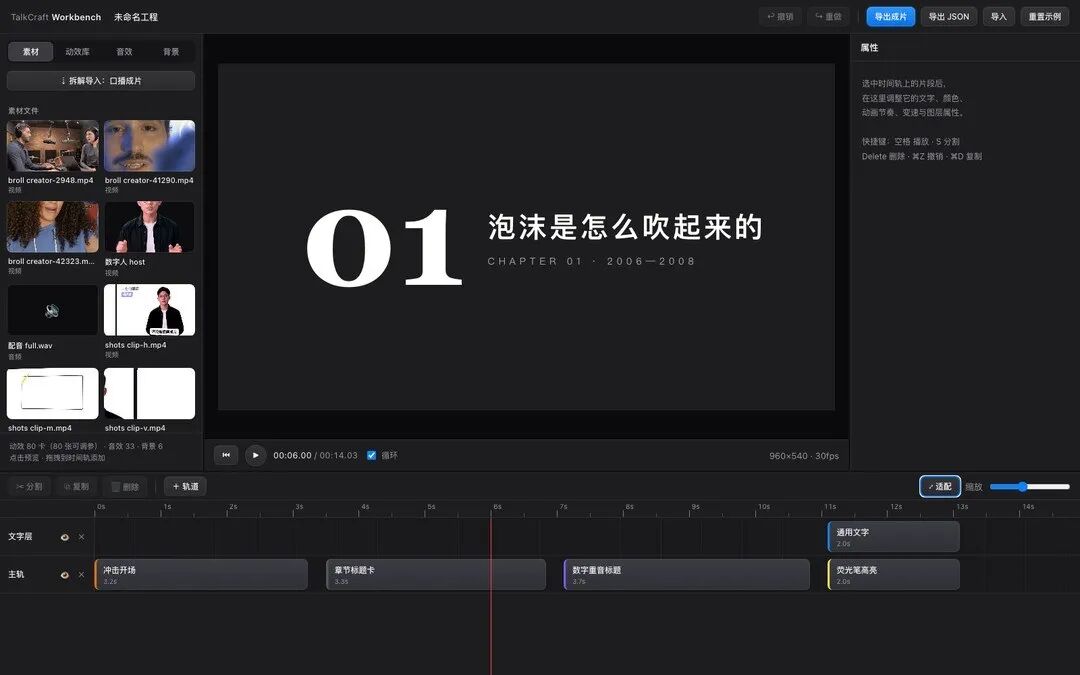
做完以后,它还会打开一个剪映式的多轨工作台,人可以在里面改文字、颜色、位置,再导出。
每个字在第几毫秒,是怎么算出来的
这是整个项目的地基:所有画面重音都要对准"某个字说出口的那一刻"。
做法分两步。第一步用语音识别模型听配音。模型事先听过海量"录音 + 文字",学会了把声音切成每 40 毫秒左右一小片,判断每一片最可能是哪个字。某个字的可能性在某一片突然冒尖,就说明这个字在那个时刻。第二步拿稿子和识别结果逐字比对,比的时候先转成不带声调的拼音,同音字也算对上;对上的字就把识别出来的时间借给稿子,英文单词这类没对上的,在前后两个对上的字之间按比例估算。
模型是开源的,下载一次以后在自己电脑的 CPU 上跑,不花钱。作者拿 110 秒的中英混合口播对比了四种方案,以 GPU 上的专用对齐模型为标准答案:
作者选的不是平均最准的,而是最差情况最好的。理由是:视频一帧 33 毫秒,平均误差几十毫秒看不出来,真正出事的是那几个偏了半秒的字,动效会挂错字。
第一份精华:和模型默认习惯相反的审美规则
这个项目的规则几乎每条都带日期和触发它的用户原话,读起来像一本返工记录。最有意思的是好几条和 AI 的默认倾向正好相反。
画面不是越动越好。 作者早期要求画面处处在动:元素落定后微微晃、背景呼吸、扫光、闪一下。9 月 4 日全部删掉,每个镜头只留一条几乎察觉不到的缓推(放大 4%~6%,摊在整个镜头里)。理由是:"观众在听人说话、看字幕,画面的活只需一条几乎察觉不到的相机呼吸。"
每镜都对,不等于整片好看。 用户看完一支片说:"后面大部分都是人物在左下角、素材在中间的方块、右边放文字,过于固定。"那支片每个镜头都过了检查,11 个镜头里 8 个用的是同一张卡。于是加了一条规定:相邻三镜,人物的位置形态和素材的摆法至少换一个;同一张卡全片不超过三分之一。
视频要装框,但不装假播放器。 镜头里放一段录屏或引用的视频,不许裸贴满屏,要包一个"有来历的物":复古浏览器窗口、杂志配图、胶片、拍立得、工程图纸等,一支片只用一种。进度条、播放键一律不要,作者的原话是:"不是真播放器就是在撒谎",观众会拿进度条对画面。
底部字幕不加任何动效,也不带标点。 整句出现、整句消失,停顿靠把一句拆成几张字幕卡。关键词弹出全片最多 3 次。
网页要"拍",不要贴。 讲一个网页时不许放一张静态截图,要像手持镜头一样滚到重点、停一下、放大或划线。也不用浏览器录屏,因为帧率不稳,懒加载会穿帮,还对不上字的时间。
库里的卡是中性的,进片要换皮。 讲宋代瓷器的片里出现发丝线白卡加蓝色图表,动作再对也是错片。所以开工第一步是从稿子判断领域,定一套颜色字体,每张卡换皮;但时长、缓动、比例这些"动作"一律不许改。作者还特意写了一条反例:不要"把风格做到运动上",人文片就放慢、娱乐片就加弹跳,都不对。
这些规则全部来自作者一个人的几支片子,没有做过对照,当作有经验的人的判断来看比较合适。
第二份精华:实测出来的数字和坑
这部分是 Opus 训练知识里没有、推理也推不出来的,只能真跑过才知道。挑几条:
FireRed 模型音频超过 210 秒就崩,内存随长度平方涨,193 秒已经要 8GB。解法是按静音切成 75 秒以内的段,结果和整段喂入几乎一样,内存降到 2.4GB。作者还试过把切点对齐到模型内部的 40 毫秒网格,结果反而更差,又撤掉了。
whisper 不要把稿子塞进提示词,前几段会整段幻觉错位。
剪口水词以稿子为准,宁可漏剪不可错剪:只剪识别结果里多出来、稿子里没有的部分;识别把稿子里的字听错了,那一段永远不剪,因为"安全"听成"啊全",那个"啊"不是口水词。过长的停顿保留一小段真实的房间底噪,不补数字静音。
人物视频是 25 帧、成片是 30 帧时,把成片改成 25 帧,动效是代码画的,改帧率零成本;硬插重复帧补到 30,人物每秒卡 5 下,旁边的动效很顺,对比更扎眼。
绿幕抠像去溢色只能用 0.18 左右,0.5 会把白 T 恤染粉。透明视频用 ffprobe 看到 yuv420p 不代表没有透明通道,解码时必须显式指定 VP9 解码器。
响度要做两遍:一遍会压掉音效的瞬间冲击;而且处理时内部会升到 192kHz,不指定输出采样率,96kHz 会漏进成片。
视频分段渲染时,声音要整条单独渲一次,每段各带声音再拼,编码器的前导延迟会让声音逐段错位。
相机推拉的最后一个关键帧要放到片尾之外:缓入缓出曲线终点速度为零,最后一个关键帧压在片尾,最后 0.8 秒画面会停死。
很细的点阵、网格放在缓推的画面里会"爬",整块看起来像画面在抖,要么把点放大,要么挪到不缩放的层。
第三份精华:108 张卡里的手感参数
这是我觉得最值钱、也最容易被忽略的部分。每张卡都有一张参数表,写着典型值和"调过头会怎样",一共 969 行,每张还附了在剪映、AE 里怎么用关键帧做出来。我把它们按类别汇总了一遍,规律非常一致。
先是一张判断表。作者描述"调过头"时,反复用的是同一批说法:
再是几组在十几张卡上反复出现的数字:
入场:小元素弹入、砸入 0.15~0.35 秒;卡片上屏 0.3~0.6 秒;柔和的解糊、逐行淡入 0.5~0.9 秒。快过 0.12~0.2 秒就"看不见过程"。
出场:约为入场的一半到七成,而且不弹。
依次出现的间隔分三档:逐字约 1 帧;想让几行读作"一组"用 0.06~0.15 秒;跟着口播"第一、第二"逐条出用 0.5~0.75 秒。小于 0.05 秒糊成一块,大于 0.2 秒左右就断开了。
停留:每个字给 0.12~0.2 秒阅读时间;金句停 2.2 秒,结论数字 1.8 秒;人名条在场 3~5 秒,少了读不完,超过 8 秒成了牛皮癣。
回弹:柱状图、清单、纠错一律不弹("数据不该弹");要弹时过冲 5% 左右最好,10% 是上限;一张卡只给一个动作弹。
模拟真人操作:中文打字每秒 8.5~11 字,慢了观众会去读输入框,快了像机器代打;打完停 0.33 秒再点发送,0 秒像脚本,超过 0.6 秒像卡住。
这些不是物理定律,是作者一张张调出来的手感。但同一条阈值在十几张卡上数值都很接近,可信度比单条规则高得多。它们也不只能用在口播里,做片头字卡、人物介绍条、手机聊天画面,甚至网页和 PPT 的动画,都能直接拿来当起点。
价值不大的部分
直接说:
剪映式的工作台工程量很大,但和"做好一条视频"关系不大。
规则写得太细。主文档 62KB,硬性规定一条接一条,明显是写给容易忘事的模型看的。Opus 5.5 不需要这么密的约束,照单全收反而容易做死板。
派子代理做评审的那一整套流程(怎么派、怎么判断它干完了、拿不到报告怎么办),对已经在用子代理的人意义不大,而且审片最后还得人来看。
每张卡的"已知坑"多数是推理,我抽了几张看,写的都是"这样会读作什么"的判断,没有实测记录。真正有分量的是参数表。
素材搜索只能搜到泛泛的空镜,原因前面说了。
和 video-shotcraft 放在一起看
两个项目同一个作者,路数一样:用代码画画面,配一套调过的镜头卡,再加一份审美规则。区别在题材,video-shotcraft 拍产品宣传片,讲究节奏和冲击;video-talkcraft 做口播,讲究跟着人声走、不抢人说话。talkcraft 有 18 张卡就是从 shotcraft 移植过来的,按"服务讲述、不炫技"的标准挑过。
多出来的是"声音"这条线:字级时间、剪口水词、音效能不能听见。这一块是 shotcraft 没有的。
用之前要知道的几件事
许可是非商用的(PolyForm Noncommercial)。个人、学习、研究免费,做出的视频归你;但把这个工具用于带货、接单、公司宣传这类商业用途,要先找作者授权。
需要自己去 Pexels、Pixabay 免费注册拿接口密钥;用 Fish Audio 合成配音也要一个密钥。
作者在 Mac 上开发,脚本里有不少 Mac、Linux 的写法,Windows 上能不能直接跑通我没有试。
最后
简单总结一下:video-talkcraft 想做的是"口播视频全自动",这件事本身 Opus 5.5 加上 Remotion 也能做个大概。它真正留下来的,是作者在几支片子里被挑出来的审美规则、一批踩过才知道的数字,以及 108 张卡上调好的手感参数。
如果只想读,最值得看的是这几处:
references/cards/*.md 里每张卡的"参数表":典型值和调过头会怎样;
references/cinematography.md:运动做减法、排版和版式轮换、代码层的坑;
references/design-language.md 第 0 节和第 1.3 节:从稿子定风格、视频怎么装框;
references/host-footage.md:人物视频的帧率、抠像和透明通道;
scripts/timestamps_cpu.py 和 scripts/voice_trim.py 开头的注释:识别方案对比,以及以稿为准剪口水词。
希望这篇对你有帮助。对 AI 做视频感兴趣的朋友,欢迎在留言区一起交流。
项目地址:github.com/Vincentwei1021/video-talkcraft